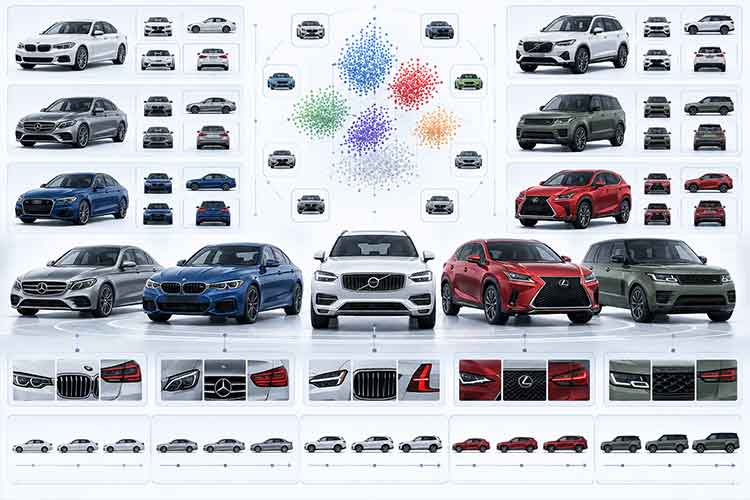
摘要:该数据集主要面向汽车品牌、具体车型以及不同生产代际的细粒度视觉识别任务,通过按照“品牌(Make)—车型(Model)—代际(Generation)”的层级结构对车辆图像进行人工标注,可用于车辆属性识别、车型分类、代际判别和智能交通视觉分析等研究。
数据集概述
该数据集共包含 41,521 张汽车图像,图像来源包括互联网公开图片以及手机实拍照片。数据覆盖 24 个汽车品牌、90 个车型和 196 个车型代际类别,最终以具体车型的代际作为分类类别,例如 Audi Q7 2009–2015、Toyota Camry 2012–2017、Hyundai Accent 2006–2011 等。数据集在构建过程中尽可能保持类别平衡,训练集中每个类别平均约 189 张图像,最少约 73 张,最多约 384 张,类别样本数量标准差约为 48,具有典型的大规模细粒度车辆分类特征。
数据结构与关键特征
数据集主要位于 car-dataset-200/riotu-cars-dataset-200 目录下,并按照品牌—车型—代际的层级方式组织。例如 audi 目录下包含 a7、a8、q7、q8 等车型,bmw 目录下包含 bmw-series5、bmw-series7、bmw-x5 和 bmw-x6,而 cadillac-escalade 还进一步划分为 2000-2006、2006-2013、2013-2020 和 2020-2021 等代际。数据覆盖 Audi、BMW、Cadillac、Chevrolet、Ford、Honda、Hyundai、Kia、Lexus、Mercedes、Nissan、Porsche、Toyota 等 24 个品牌。其核心难点是不同代际车辆之间外观差异较细微,而同一类别又存在拍摄角度、车身颜色、背景、光照和遮挡等较大变化,因此对模型的细粒度特征提取能力要求较高。
应用价值与研究方向
该数据集适合用于汽车品牌识别、车型分类、车辆代际识别、细粒度图像分类以及车辆属性分析等研究方向。算法方面可采用 ResNet、EfficientNet、DenseNet、ConvNeXt、Swin Transformer 和 Vision Transformer 等深度学习模型进行分类,并进一步研究注意力机制、局部关键区域特征提取、度量学习以及层次化分类方法。还可构建“品牌识别 → 车型识别 → 代际识别”的多阶段车辆识别系统,并与车辆目标检测、车牌识别、车辆重识别等任务结合,应用于智能停车、交通监控、车辆检索和边缘端实时车辆识别系统。
数据集来源
由张家梁(Bob)整理并于2026年在7zcode平台公开发布。
数据集信息
免责声明与引用
数据仅用于科研与教学用途。若用于商业场景,请自行核验数据许可。如需引用,请在论文或报告中注明数据集名称与版本号。
作者信息
作者:Bob (张家梁)
项目编号:Datasets-775
文件大小:7.1G
原创声明:本数据集为整理作品
联系方式
开源协议
本项目采用AGPL-3.0开源协议,允许个人和组织自由使用、修改和分发代码,但基于本项目的衍生作品必须同样开源,且用于提供网络服务时需向用户提供完整源代码。本项目仅供学习研究使用,作者不对使用本项目产生的任何后果承担责任,使用者应遵守当地法律法规,合理合法使用本项目。如本项目对您的研究或工作有所帮助,欢迎引用并注明出处。

评论(0)