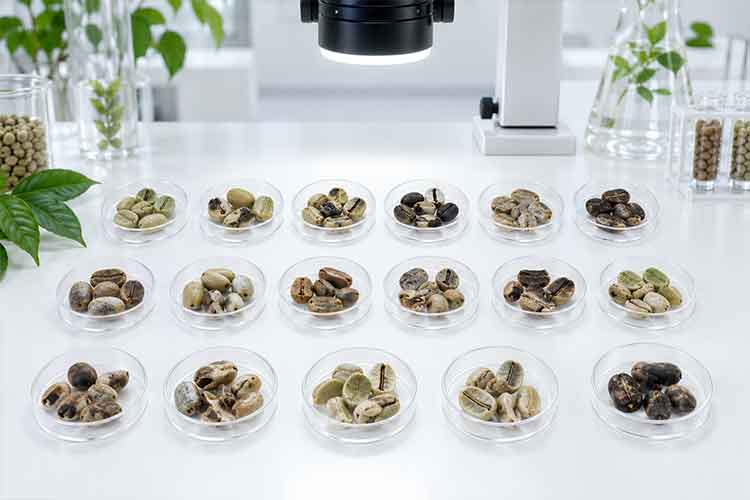
摘要:该数据集主要面向生咖啡豆外观缺陷识别与品质分级研究,提供多种典型缺陷类型的原始图像,可用于深度学习分类模型训练、咖啡豆自动质检和智能农产品品质评价。
数据集概述
该数据集包含 17 类阿拉比卡生咖啡豆缺陷图像,原始图像分辨率为 500×500 像素。缺陷类型覆盖 Broken、Cut、Dry Cherry、Fade、Floater、Full Black、Full Sour、Fungus Damage、Husk、Immature、Parchment、Partial Black、Partial Sour、Severe Insect Damage、Shell、Slight Insect Damage 和 Withered 等常见品质异常。数据可直接用于多类别图像分类,并已被用于训练深度学习模型和构建在线咖啡豆缺陷识别应用。
数据结构与关键特征
数据集按照缺陷类别分别建立文件夹,每个目录对应一种咖啡豆缺陷状态,共 17 个类别。其关键特点是类别定义较细,既包含机械破损类缺陷,如 Broken、Cut、Shell,也包含成熟度与干燥相关问题,如 Immature、Dry Cherry、Withered,还包括颜色异常、发酵酸败、真菌损伤和虫害等质量问题,例如 Full Black、Full Sour、Fungus Damage、Severe Insect Damage 等。因此该数据集具有明显的细粒度外观分类特征,对模型识别纹理、颜色、形状和局部损伤区域的能力要求较高。
应用价值与研究方向
该数据集适合用于咖啡豆缺陷分类、品质分级、农产品视觉检测、自动质检和智能分选等研究方向。算法方面可以采用 ResNet、EfficientNet、DenseNet、ConvNeXt、Swin Transformer 和 Vision Transformer 等模型进行17分类,并进一步研究注意力机制、局部缺陷特征增强、数据增强、类别不平衡处理和可解释性分析。还可将分类模型与工业相机、传送带和自动分选设备结合,构建“图像采集—缺陷识别—质量分级—自动剔除”一体化咖啡豆智能检测系统。
数据集来源
由张家梁(Bob)整理并于2026年在7zcode平台公开发布。
数据集信息
免责声明与引用
数据仅用于科研与教学用途。若用于商业场景,请自行核验数据许可。如需引用,请在论文或报告中注明数据集名称与版本号。
作者信息
作者:Bob (张家梁)
项目编号:Datasets-786
文件大小:73M
原创声明:本数据集为整理作品
联系方式
开源协议
本项目采用AGPL-3.0开源协议,允许个人和组织自由使用、修改和分发代码,但基于本项目的衍生作品必须同样开源,且用于提供网络服务时需向用户提供完整源代码。本项目仅供学习研究使用,作者不对使用本项目产生的任何后果承担责任,使用者应遵守当地法律法规,合理合法使用本项目。如本项目对您的研究或工作有所帮助,欢迎引用并注明出处。

评论(0)