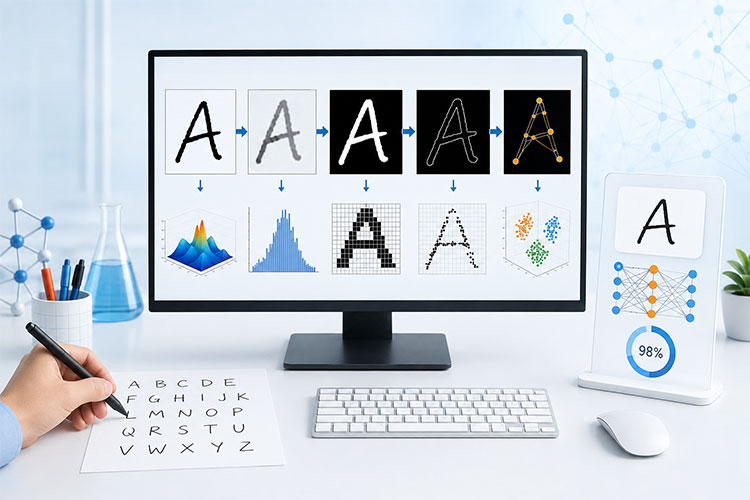
摘要:针对手写英文字母在书写风格、笔画粗细、字符尺寸和图像背景方面存在差异的问题,本文设计并实现了一套基于 MATLAB 的离线手写英文字母图像识别系统。
内容简介
针对手写英文字母在书写风格、笔画粗细、字符尺寸和图像背景方面存在差异的问题,本文设计并实现了一套基于 MATLAB 的离线手写英文字母图像识别系统。系统以传统数字图像处理和模板匹配为核心,面向背景较简洁、字符彼此分离的英文大写字母图像,完成从训练数据准备、模板生成、图像预处理、字符分割、类别判定到结果输出的完整流程。系统由 HandwritingOCRApp.m 主程序、dataset 训练数据集、train.m 模板训练脚本和 templates.mat 模板库构成,形成了结构清晰、便于验证和扩展的工程实现。
在算法方面,首先对输入图像进行灰度化,并采用面向深色前景的自适应二值化方法减弱局部光照不均的影响;随后利用连通域面积约束去除孤立噪点,通过空白行、空白列扫描完成多行文本与单字符区域分割;再将字符规范化为 42×24 的二值图像,与 676 个训练模板逐一计算二维相关系数,选择最大相关系数所对应的字母类别作为识别结果。系统界面采用 uifigure 和 uigridlayout 构建中文三栏布局,提供图像导入、参数设置、原图与处理图对照、识别结果、字符数量、图像尺寸、处理耗时、运行日志、文本导出和语音朗读等功能。
实验使用 3 幅图像进行验证,累计包含 44 个英文字母,处理时间分别为 0.212 s、0.755 s 和 0.127 s,三组字母序列均与标注一致。结果表明,系统在规定条件下能够完成字符检测、分割与识别。受模板规模和采集条件限制,当前结果不能代表开放场景泛化性能;后续可通过数据扩增、拒识机制和卷积神经网络提升鲁棒性。
文档概述
文档信息
版本:初稿
页数:47页
字数:17432个字
格式:word(可编辑)
图表:10张图、8张表、8个公式
文档目录
第一章 绪论 1
1.1 研究背景 1
1.2 研究意义 2
1.3 国内外研究现状 3
1.3.1 传统字符识别方法 3
1.3.2 学习型识别方法 3
1.4 本文主要研究内容 4
1.5 论文组织结构 5
第二章 系统需求分析与总体设计 6
2.1 系统目标与应用边界 6
2.2 功能需求分析 6
2.3 性能与非功能需求 7
2.4 系统总体架构 8
2.5 系统识别流程 9
2.6 数据与状态设计 10
2.7 本章小结 11
第三章 手写英文字母图像预处理设计 12
3.1 预处理任务与基本原则 12
3.2 图像灰度化 12
3.3 自适应二值化 12
3.4 连通域去噪 13
3.5 边界裁剪与图像规范化 14
3.6 预处理效果分析 14
3.7 本章小结 16
第四章 字符分割与模板匹配识别方法 17
4.1 字符分割总体思路 17
4.2 多行文本分割 17
4.3 单字符分割与空格恢复 17
4.4 模板库生成 18
4.5 相关性模板匹配 19
4.6 算法复杂度分析 19
4.7 方法特点与适用性分析 20
4.8 本章小结 20
第五章 系统实现与实验分析 21
5.1 系统开发与文件组织 21
5.2 图形用户界面实现 21
5.3 核心功能实现 22
5.3.1 模型加载与图像导入 22
5.3.2 识别调度与结果显示 22
5.3.3 日志、导出与语音朗读 23
5.4 实验方案与评价指标 23
5.5 实验结果 24
5.6 结果分析 26
5.6.1 正确性分析 26
5.6.2 时间性能分析 27
5.6.3 稳定性与可用性分析 27
5.7 实验有效性与误差来源 27
5.8 本章小结 28
第六章 总结与展望 29
6.1 工作总结 29
6.2 系统不足 29
6.3 后续研究展望 30
6.4 本章小结 31
参考文献 32
致谢 33
配套项目
作者联系
作者信息
原创作者:bob(可提供二次开发有偿修改服务)
项目编号:IP-30-M
原创声明:本项目为原创作品
联系方式
开源协议
本项目采用AGPL-3.0开源协议,允许个人和组织自由使用、修改和分发代码,但基于本项目的衍生作品必须同样开源,且用于提供网络服务时需向用户提供完整源代码。本项目仅供学习研究使用,作者不对使用本项目产生的任何后果承担责任,使用者应遵守当地法律法规,合理合法使用本项目。如本项目对您的研究或工作有所帮助,欢迎引用并注明出处。

评论(1)