摘要:针对老年人语音交互中噪声干扰和意图识别准确率不足的问题,本文提出了一种基于深度学习的端到端语音指令处理系统。该系统采用Wave-U-Net进行语音降噪预处理,利用CNN-LSTM混合架构实现意图分类,有效解决了老年人语音识别场景中的关键技术难题。
项目概览
项目简介
在数据层面,本文构建了包含1800个样本的老年人语音指令数据集,涵盖15个日常生活场景类别,通过模拟老年人语音特征(语速降低18%-25%,音调降低3-6Hz),并采用6种不同音色保证数据多样性。数据集按照7:1.5:1.5的比例划分为训练集(1260样本)、验证集(270样本)和测试集(270样本),确保模型训练和评估的科学性。
系统架构采用两阶段处理流程:第一阶段使用Wave-U-Net降噪模型对输入语音进行预处理,将信噪比提升至15.93 dB(SI-SNR)和15.31 dB(SDR);第二阶段通过40维MFCC特征提取,输入CNN-LSTM意图分类器,其中CNN层负责提取局部时频特征,双向LSTM层捕捉长时序依赖关系,最终通过全连接层完成15类意图的精准识别。实验结果表明,该系统在测试集上达到89.26%的准确率和88.11%的F1分数,单次推理时间小于150毫秒,模型参数量仅为2.73M,具备良好的实时性和部署可行性。
本研究针对老年人语音数据获取困难、噪声干扰及模型部署效率等问题,构建了面向老年人语音特征的TTS合成数据集,设计了降噪与意图识别相结合的处理架构,通过预降噪提升意图识别准确率,并采用轻量化CNN-LSTM模型,在兼顾识别性能的同时提高部署效率。实验表明,该系统可应用于智能家居、健康监护等辅助生活场景,为老年人提供便捷、准确的语音交互服务。
系统架构
本系统采用语音降噪与意图识别两阶段处理架构。首先,将带噪原始语音输入Wave-U-Net降噪网络,利用包含5层下采样与5层上采样的编码器—解码器结构,结合跳跃连接融合多尺度特征,获得降噪语音,SI-SNR和SDR分别达到15.93 dB和15.31 dB。随后,提取降噪语音的40维MFCC特征,输入由两层卷积网络和单层双向LSTM组成的意图识别模型,其中卷积层通道数依次为32和64,结合批归一化、ReLU激活及最大池化提取局部时频特征,双向LSTM通过每个方向64个隐藏单元捕捉长时序依赖关系,最终由全连接层和Softmax输出15类意图的概率分布,实现从带噪语音输入到意图输出的完整处理流程,识别准确率达到89.26%,F1分数达到88.11%。
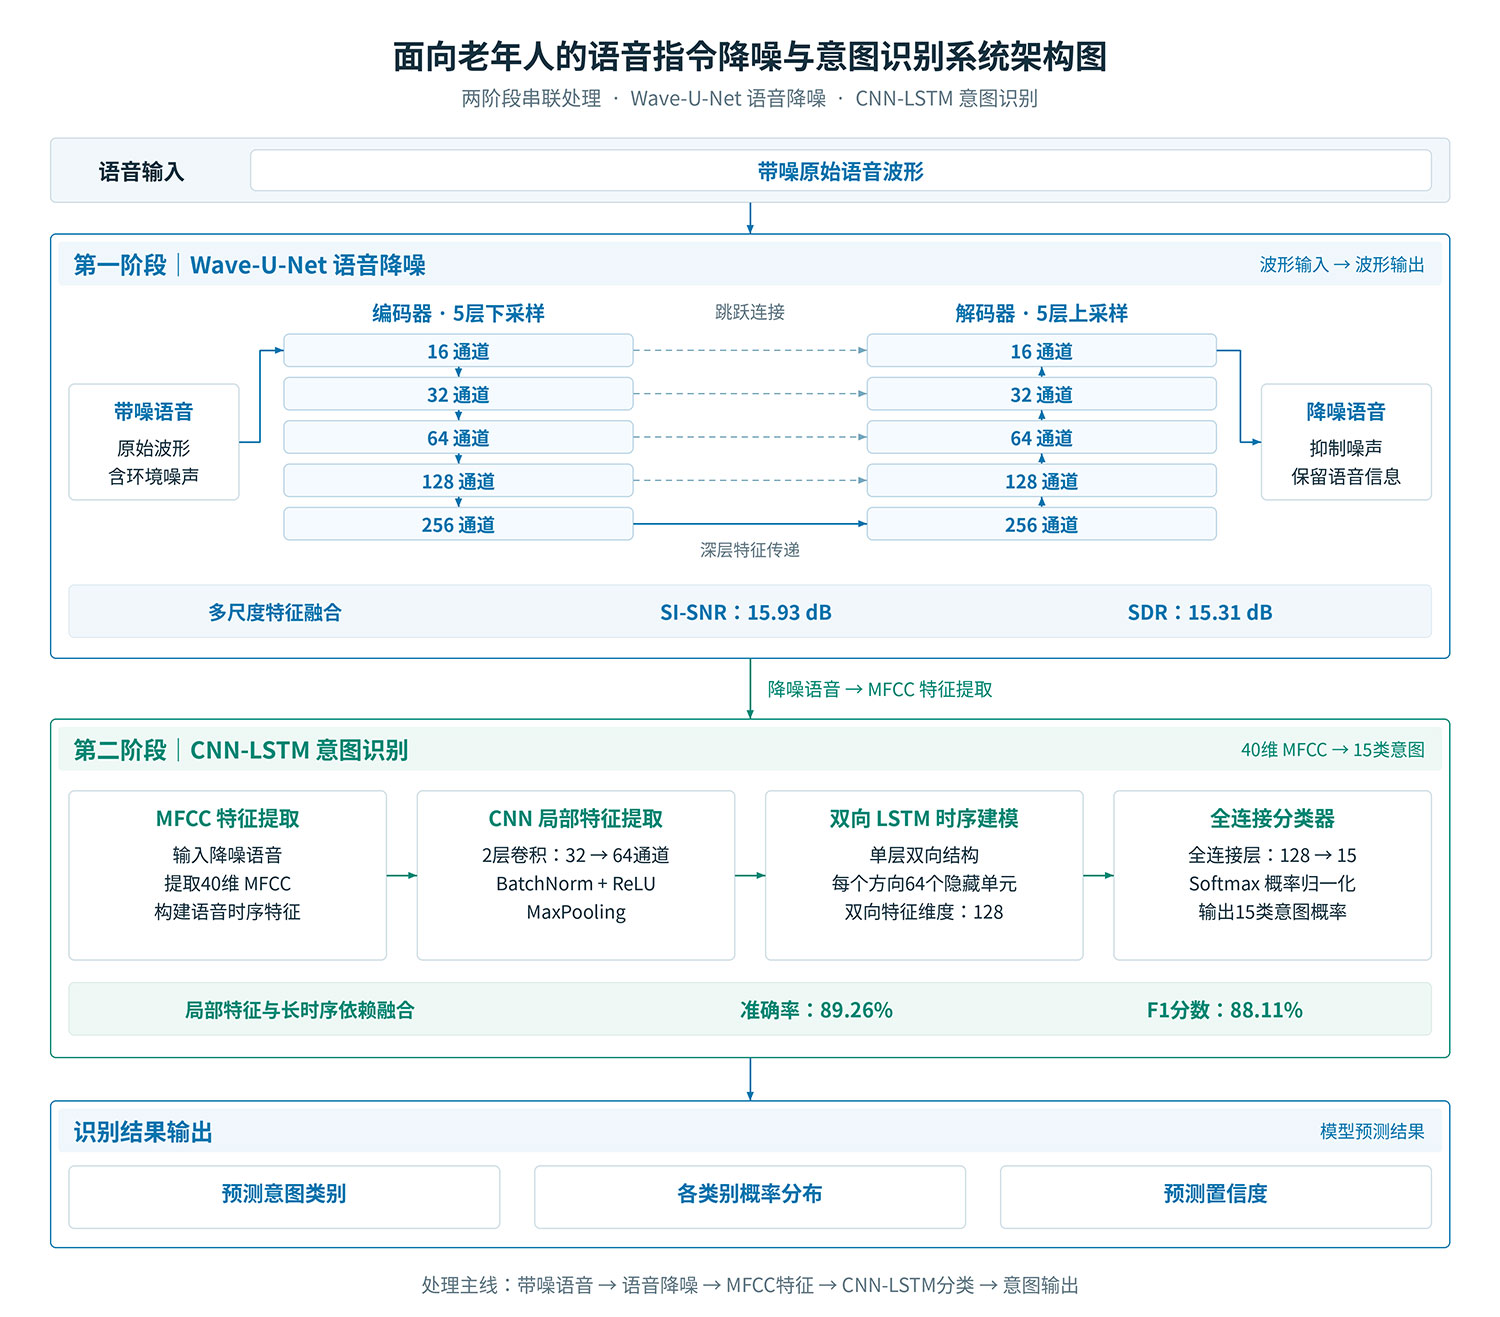
图1 系统架构图
技术创新
创新点1:面向老年人语音特征的专用数据集构建
针对老年人语音数据获取困难及隐私保护要求较高的问题,构建专用语音数据集,通过降低语速、调整音调模拟老年人语音特征,并引入6种音色,覆盖15类日常场景,每类设置20种表达方式,增强数据的多样性。模型在实验中取得89.26%的识别准确率,表明该数据构建方法具有一定可行性。
创新点2:语音降噪与意图识别的两阶段协同架构
针对环境噪声影响语音指令识别的问题,构建由Wave-U-Net降噪网络与CNN-LSTM识别模型组成的两阶段处理架构,先抑制语音中的噪声,再提取MFCC特征进行意图分类。该架构通过模块化设计衔接降噪与识别过程,便于独立优化和维护,对比实验中识别准确率较无降噪方案提升约5%~8%。
创新点3:面向边缘部署的轻量化CNN-LSTM模型设计
针对深度学习模型计算开销较大、边缘部署受限的问题,采用两层卷积与单层双向LSTM构建轻量化识别模型,将卷积通道数控制为32和64,兼顾局部特征提取与时序建模能力。模型参数量为2.73M,在所测环境下推理时间低于150ms,为CPU及树莓派等边缘设备上的语音交互应用提供部署基础。
数据集
本研究构建了包含1800个语音样本的老年人语音指令数据集,涵盖15类日常生活场景,每类设置20种不同表达方式,并采用6种音色模拟不同老年人的语音特征,以增强数据的多样性。数据集按照70%∶15%∶15%的比例划分为训练集、验证集和测试集,分别包含1260个、270个和270个样本,用于模型训练、参数调优与性能评估。
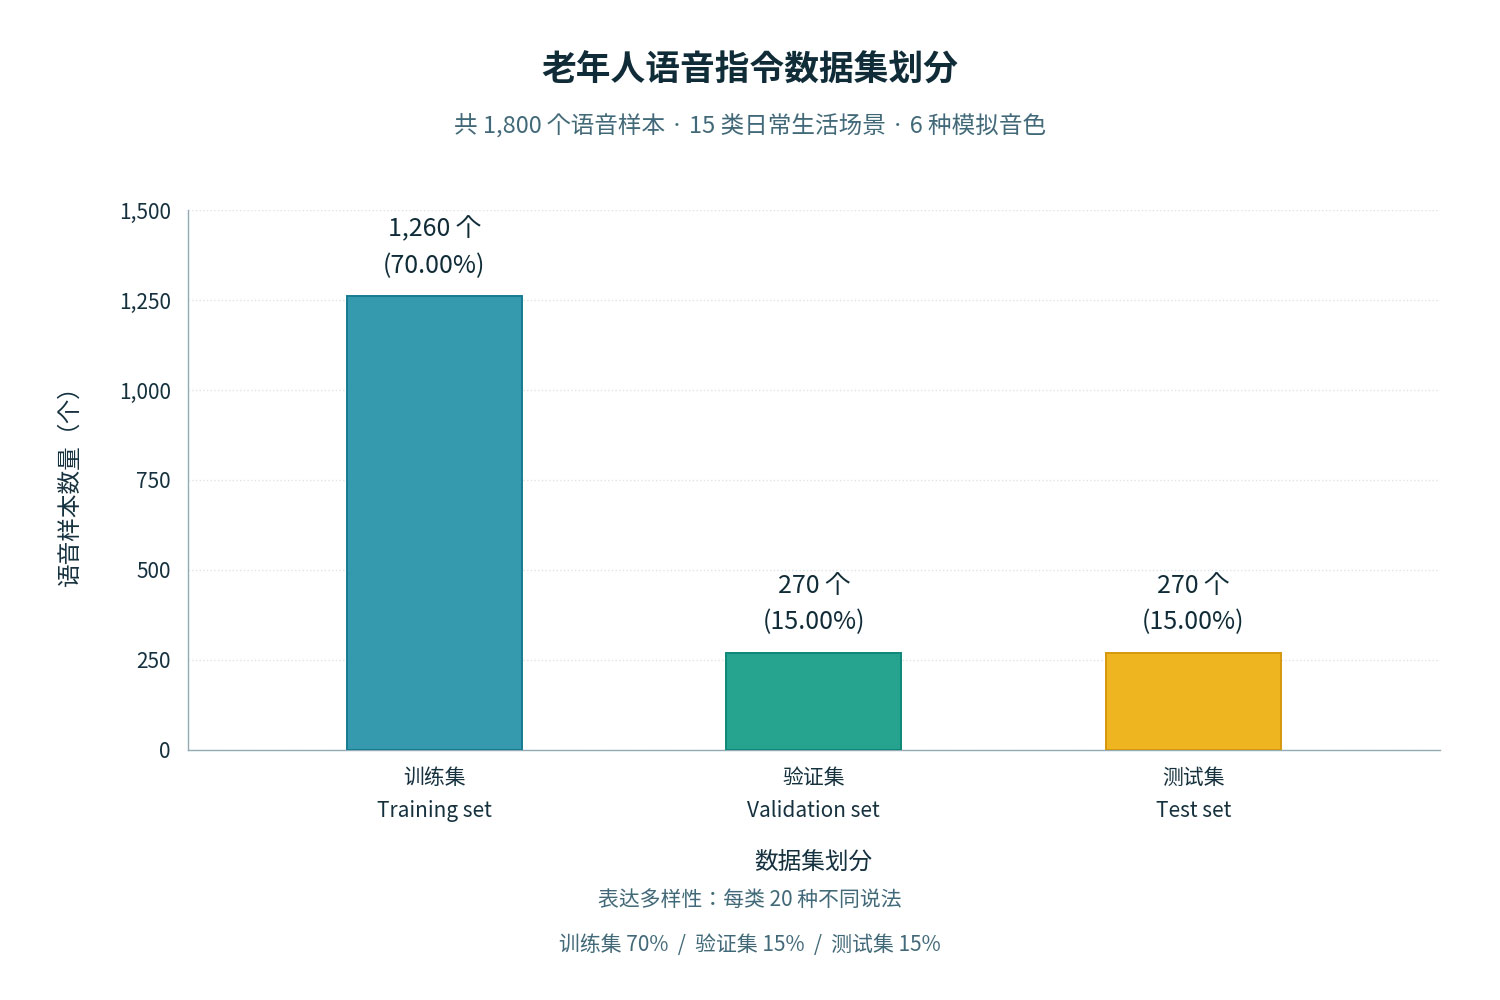
图2 数据集直方图
模型训练
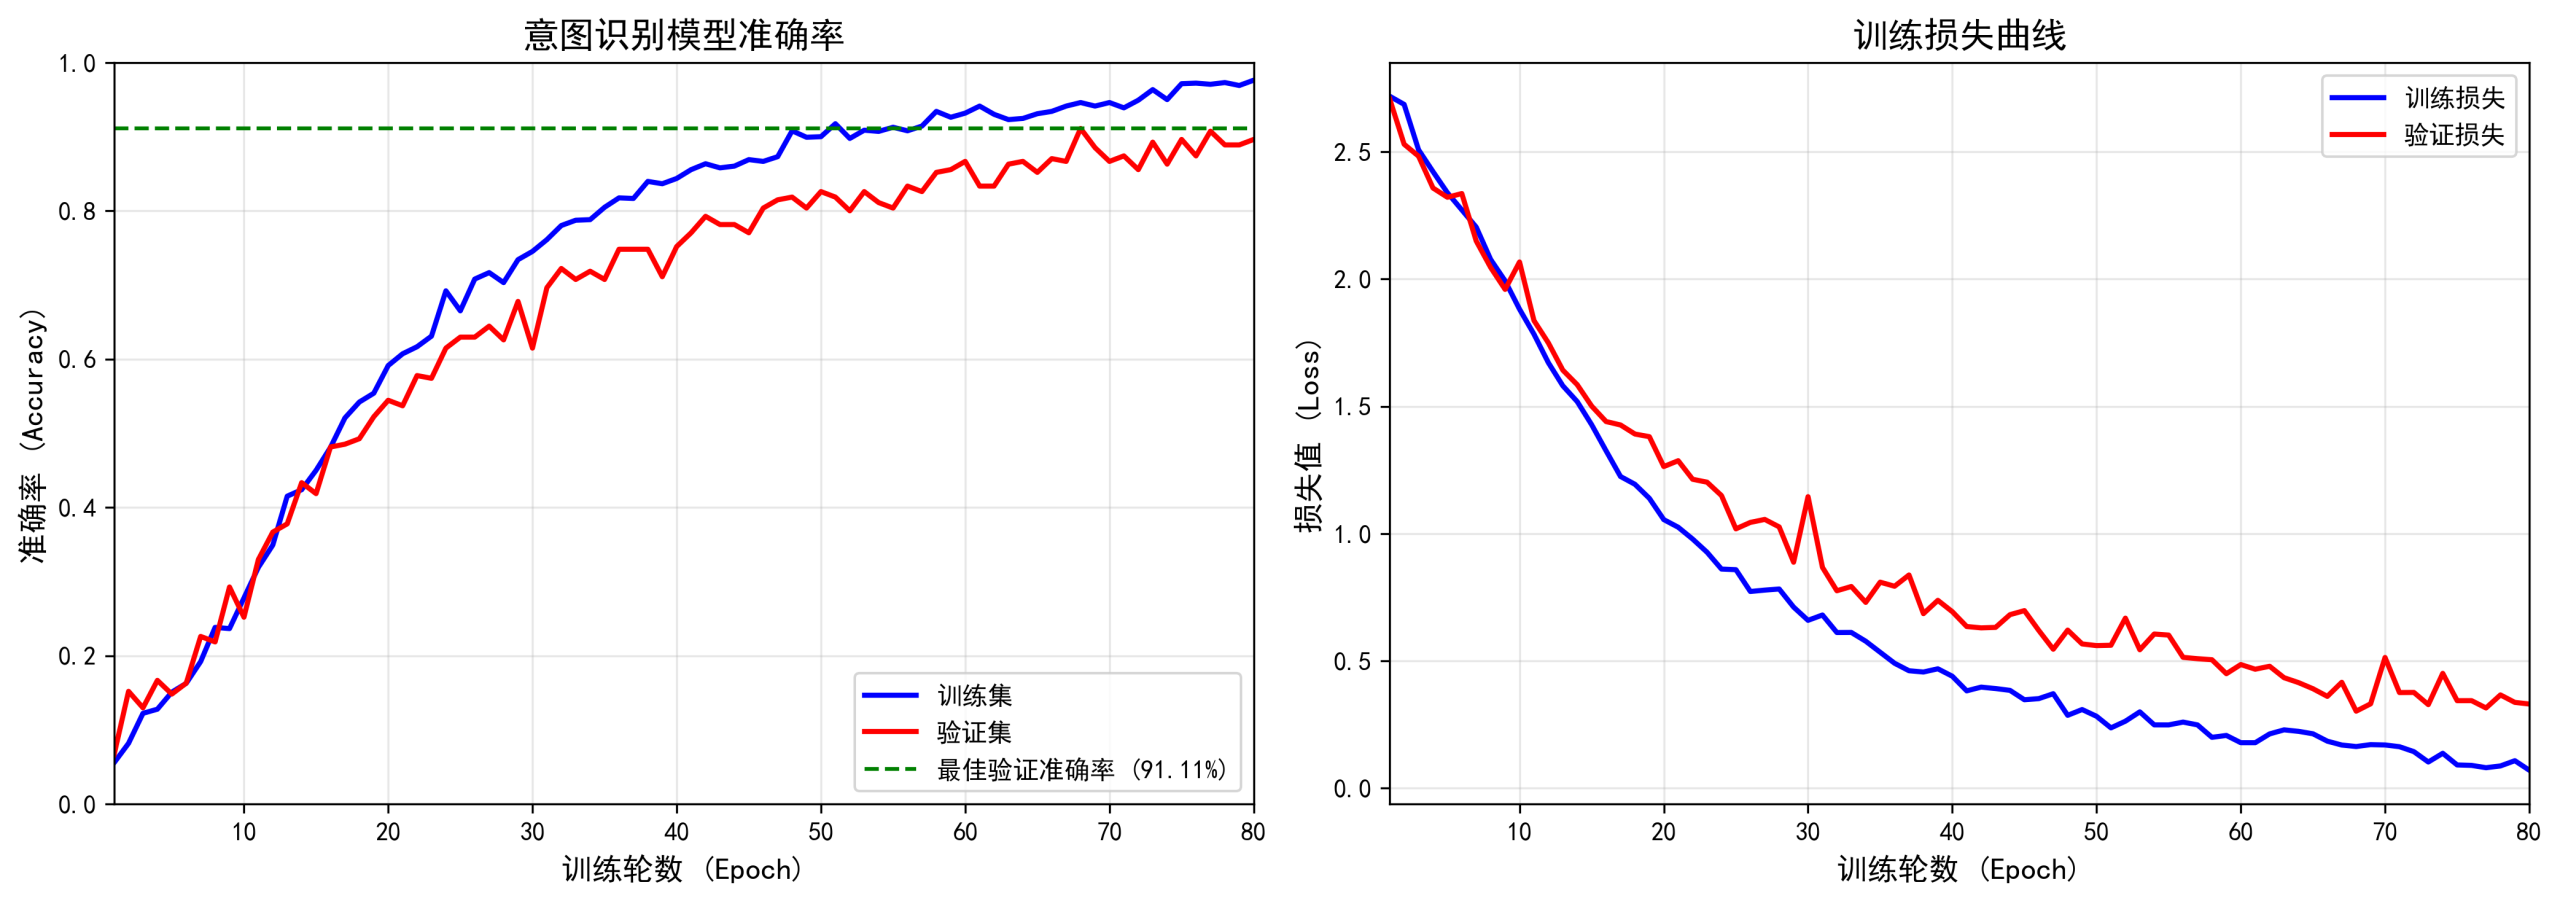
图3 意图识别训练曲线
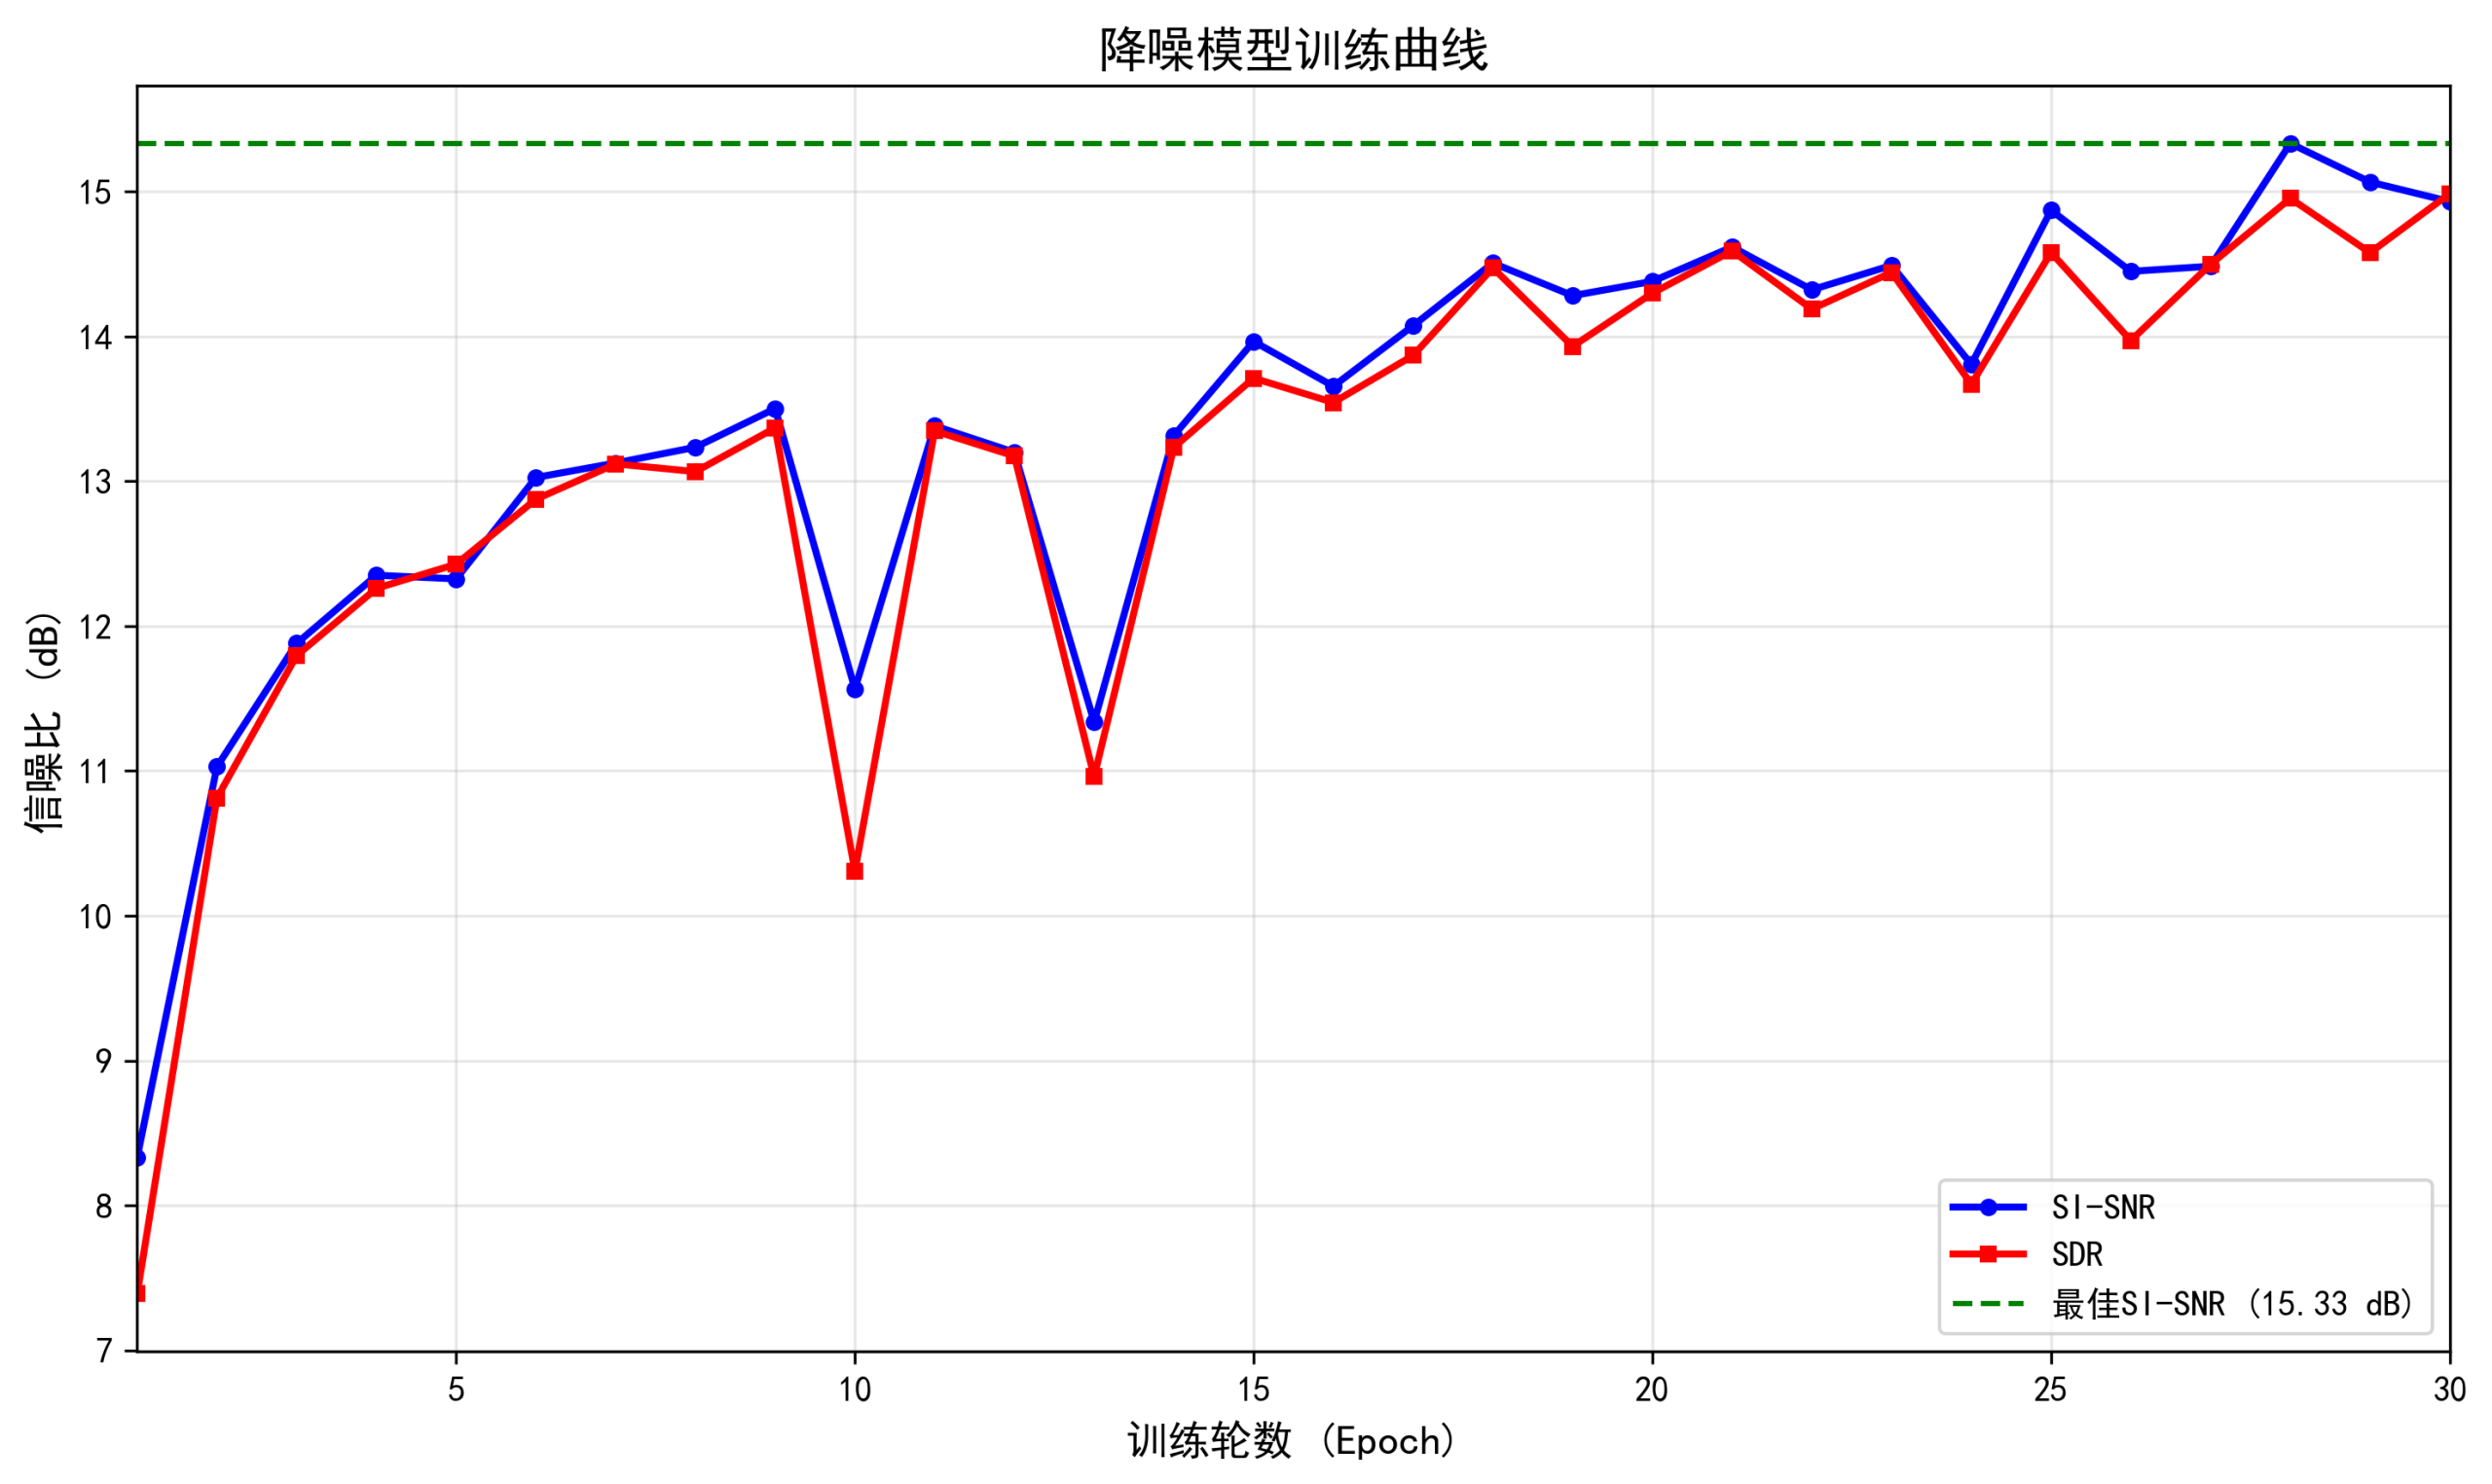
图4 降噪模型训练曲线
快速开始
用户可运行 python login.py 启动图形界面进行语音识别,或执行 python training/train_intent.py 训练意图识别模型。
环境要求
本系统基于Python 3.8+和PyTorch 2.0+开发,推荐使用CUDA 11.8+(可选),需要至少8GB RAM,通过 pip install -r requirements.txt 安装PyQt5、librosa、soundfile等必要依赖包。
运行展示
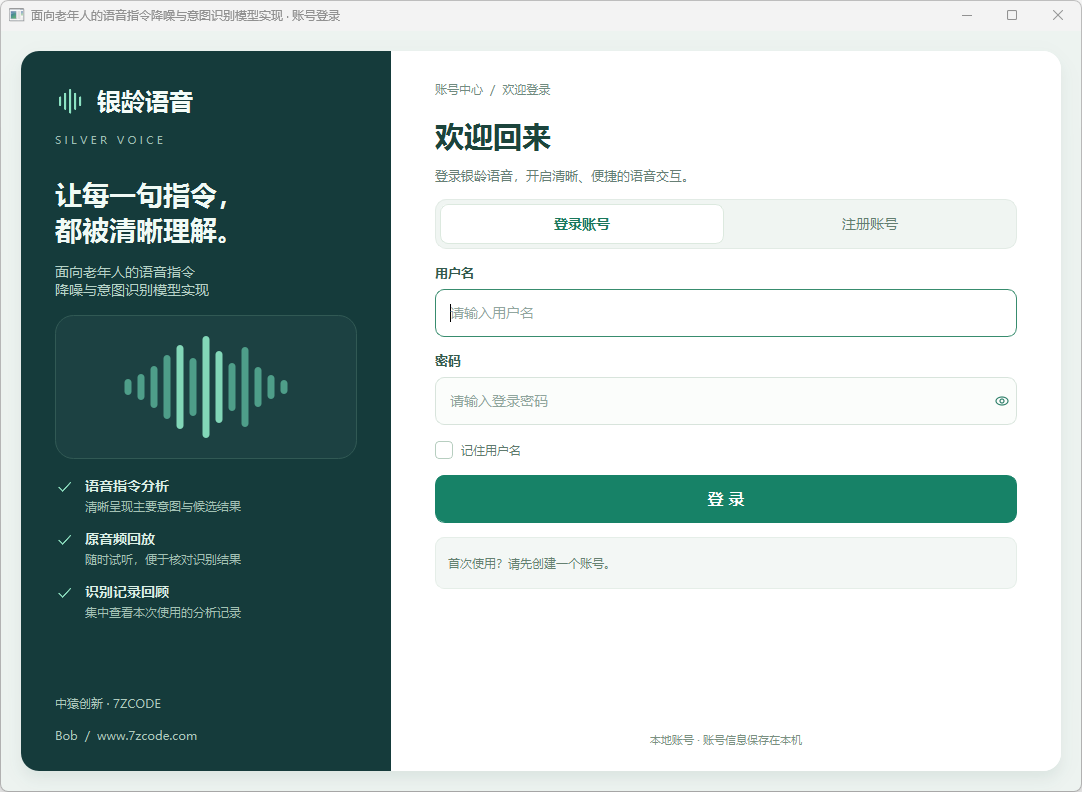
图5 登录账号
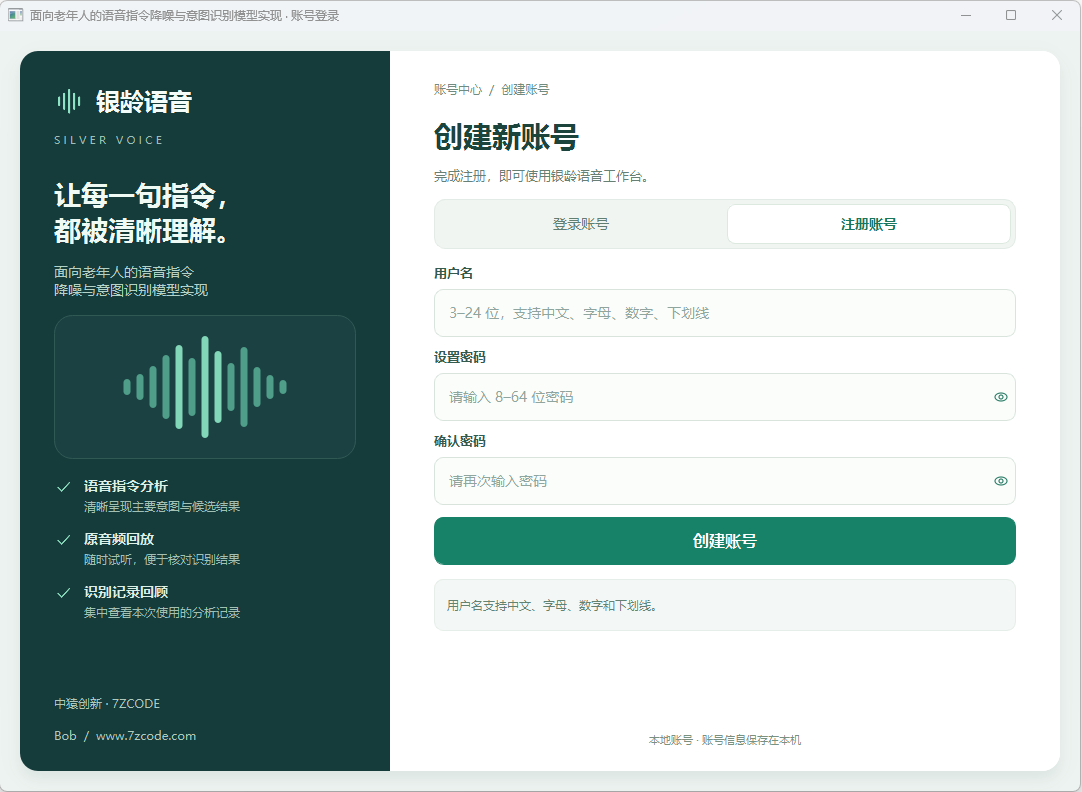
图6 注册账号
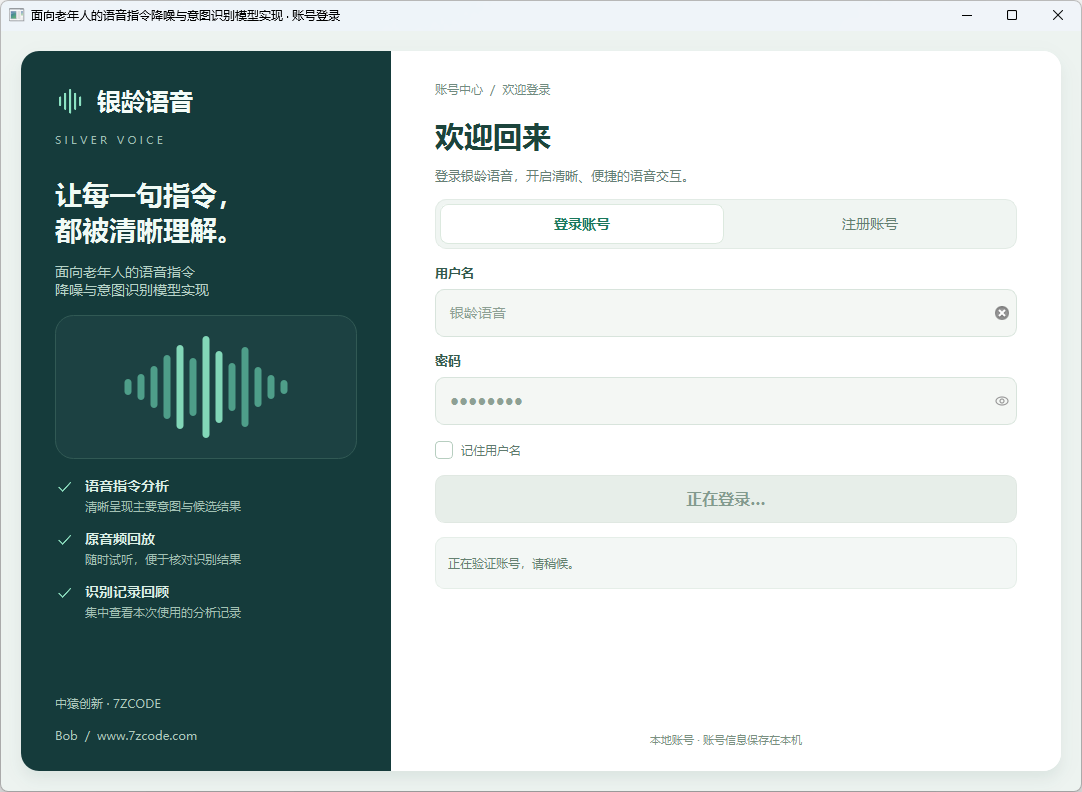
图7 正在登录
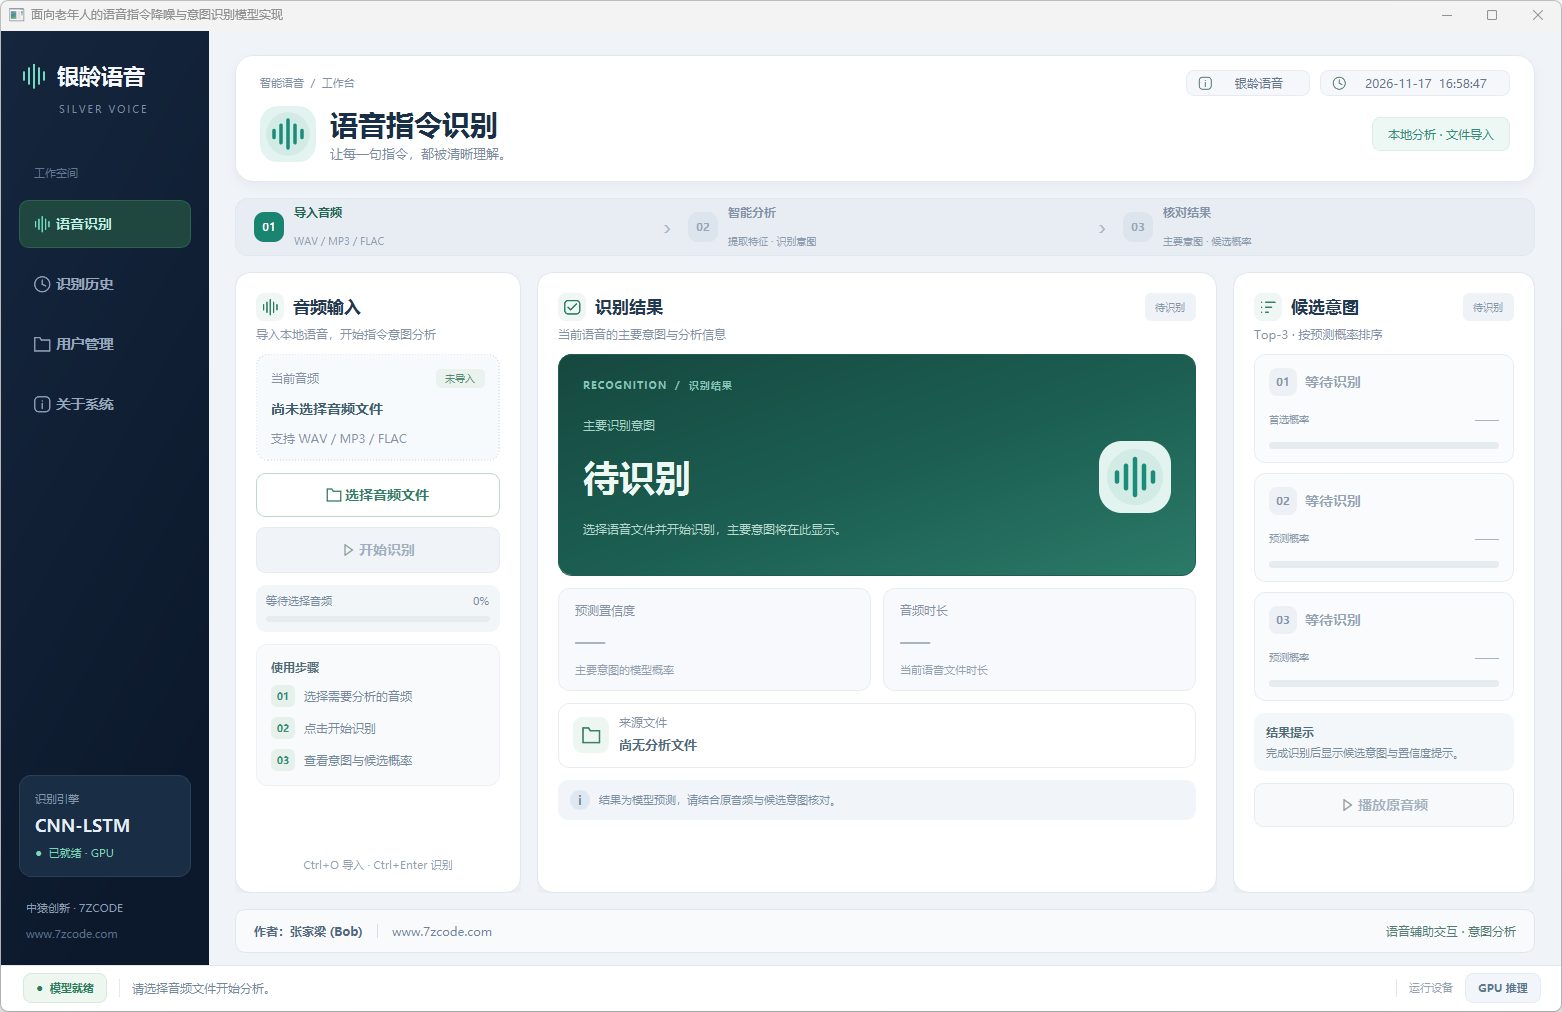
图8 系统主界面

图9 语音指令识别:播放新闻

图10 语音指令识别:播放音乐

图11 语音指令识别:测量血压

图12 语音指令识别:查时间

图13 语音指令识别:吃药提醒

图14 语音指令识别:打电话

图15 语音指令识别:打开窗帘

图16 语音指令识别:调低温度

图17 语音指令识别:调高温度

图18 语音指令识别:发消息

图19 语音指令识别:关闭窗帘

图20 语音指令识别:关灯

图21 语音指令识别:开灯

图22 语音指令识别:其他
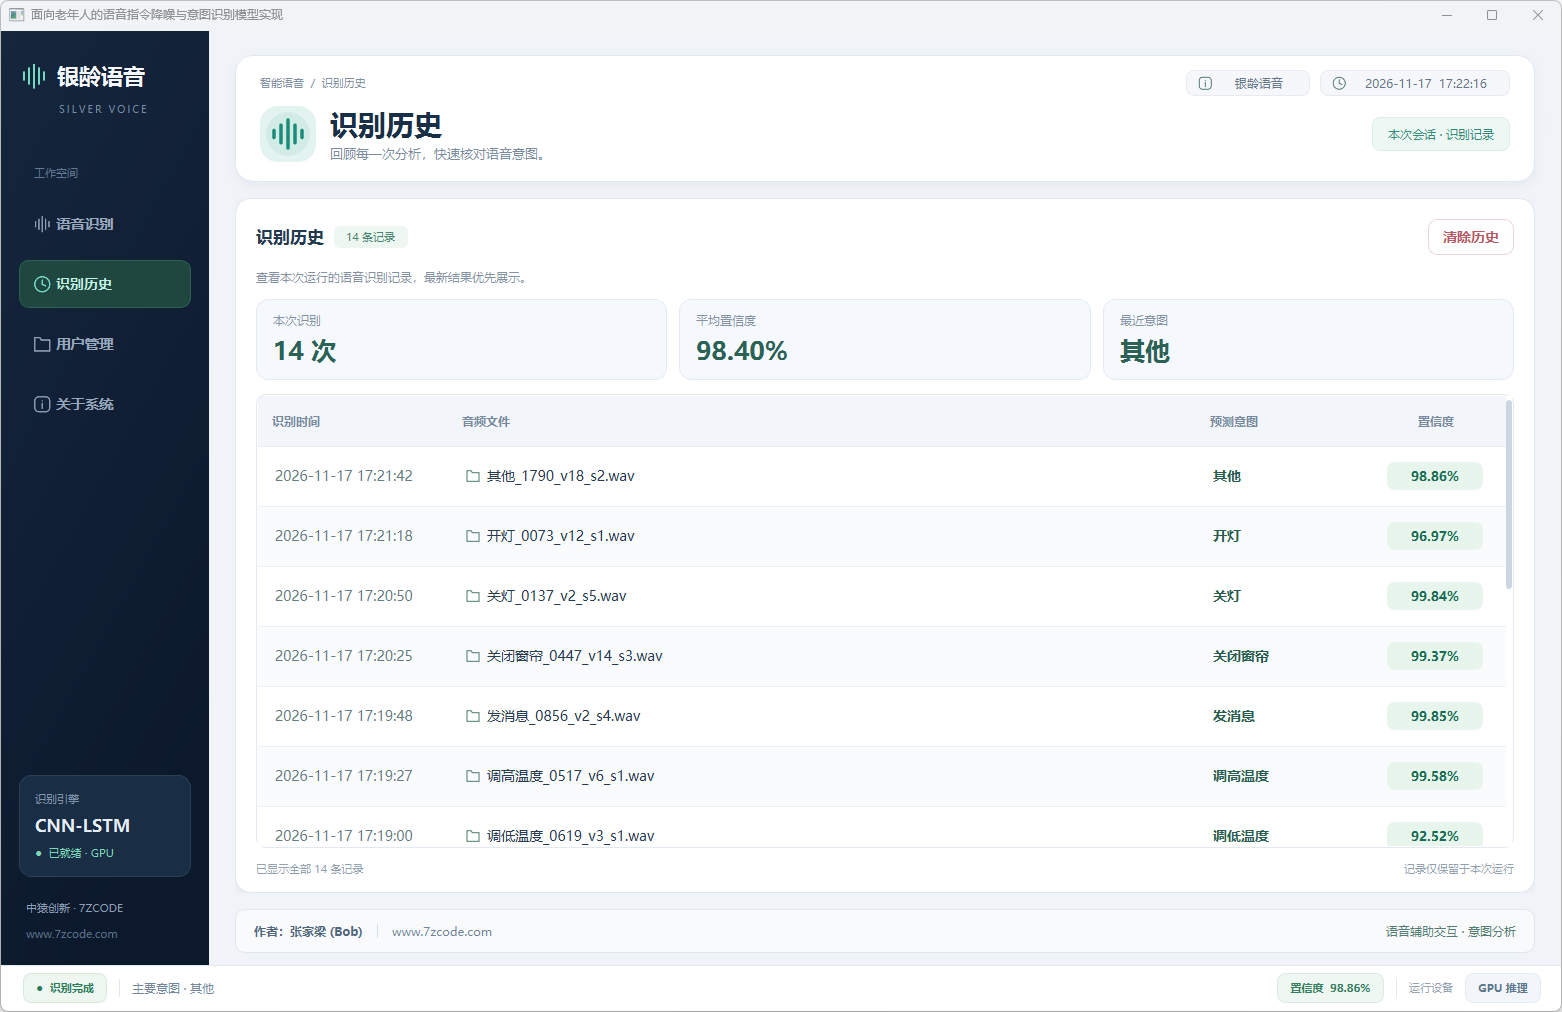
图23 识别历史记录
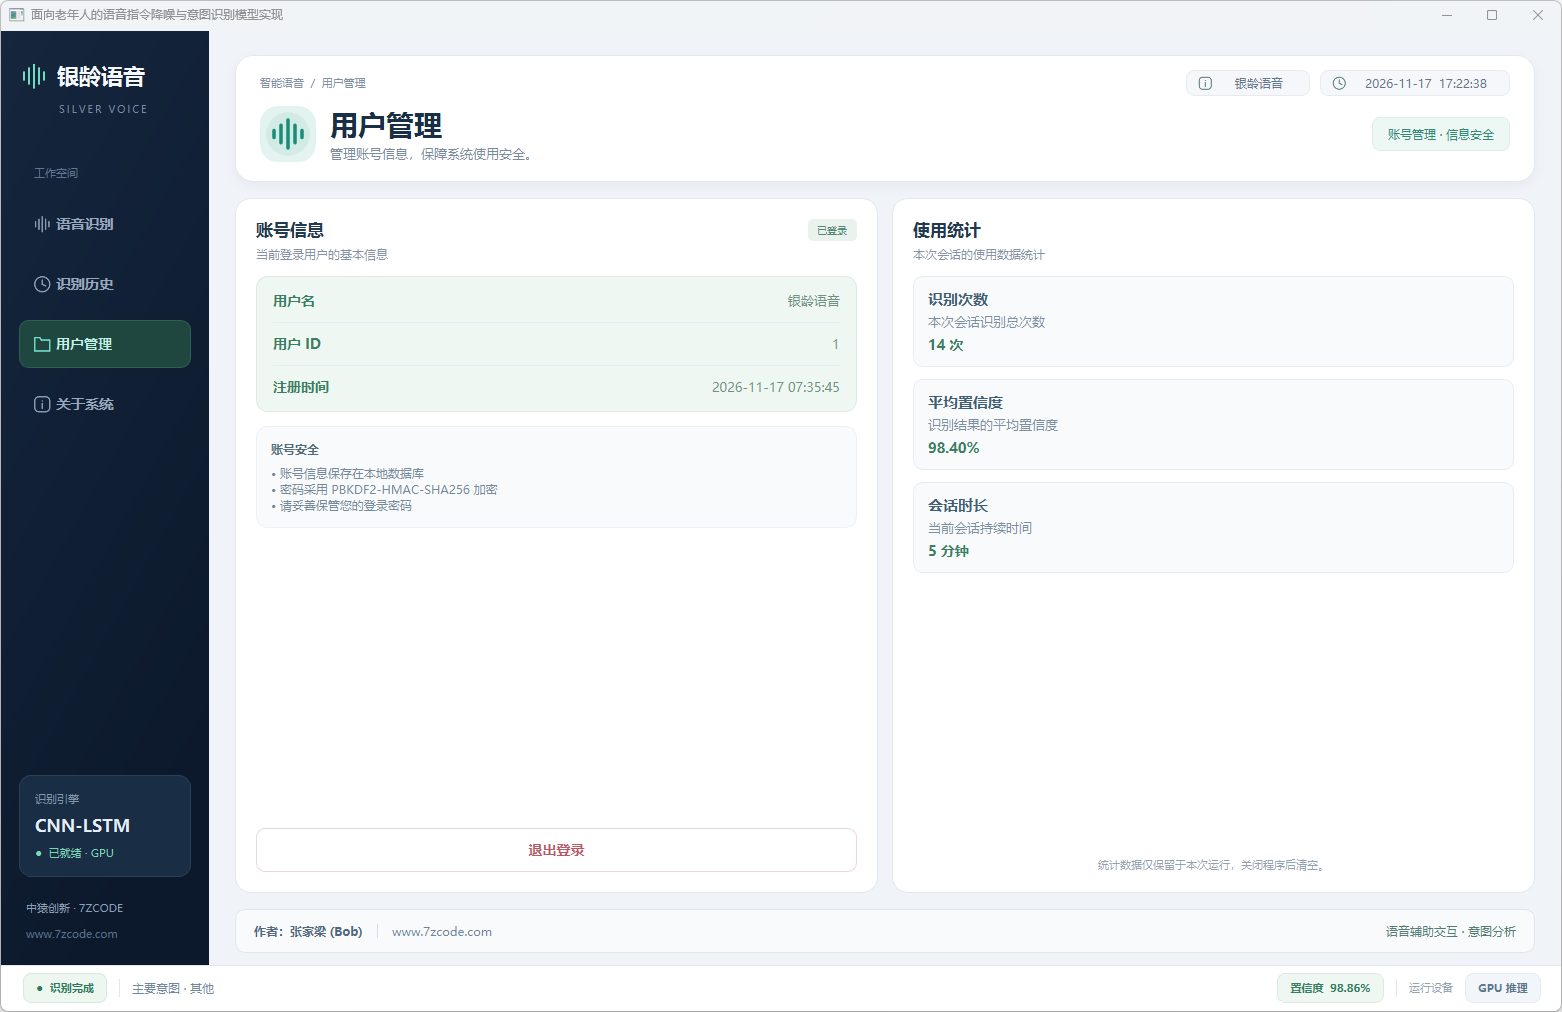
图24 用户管理
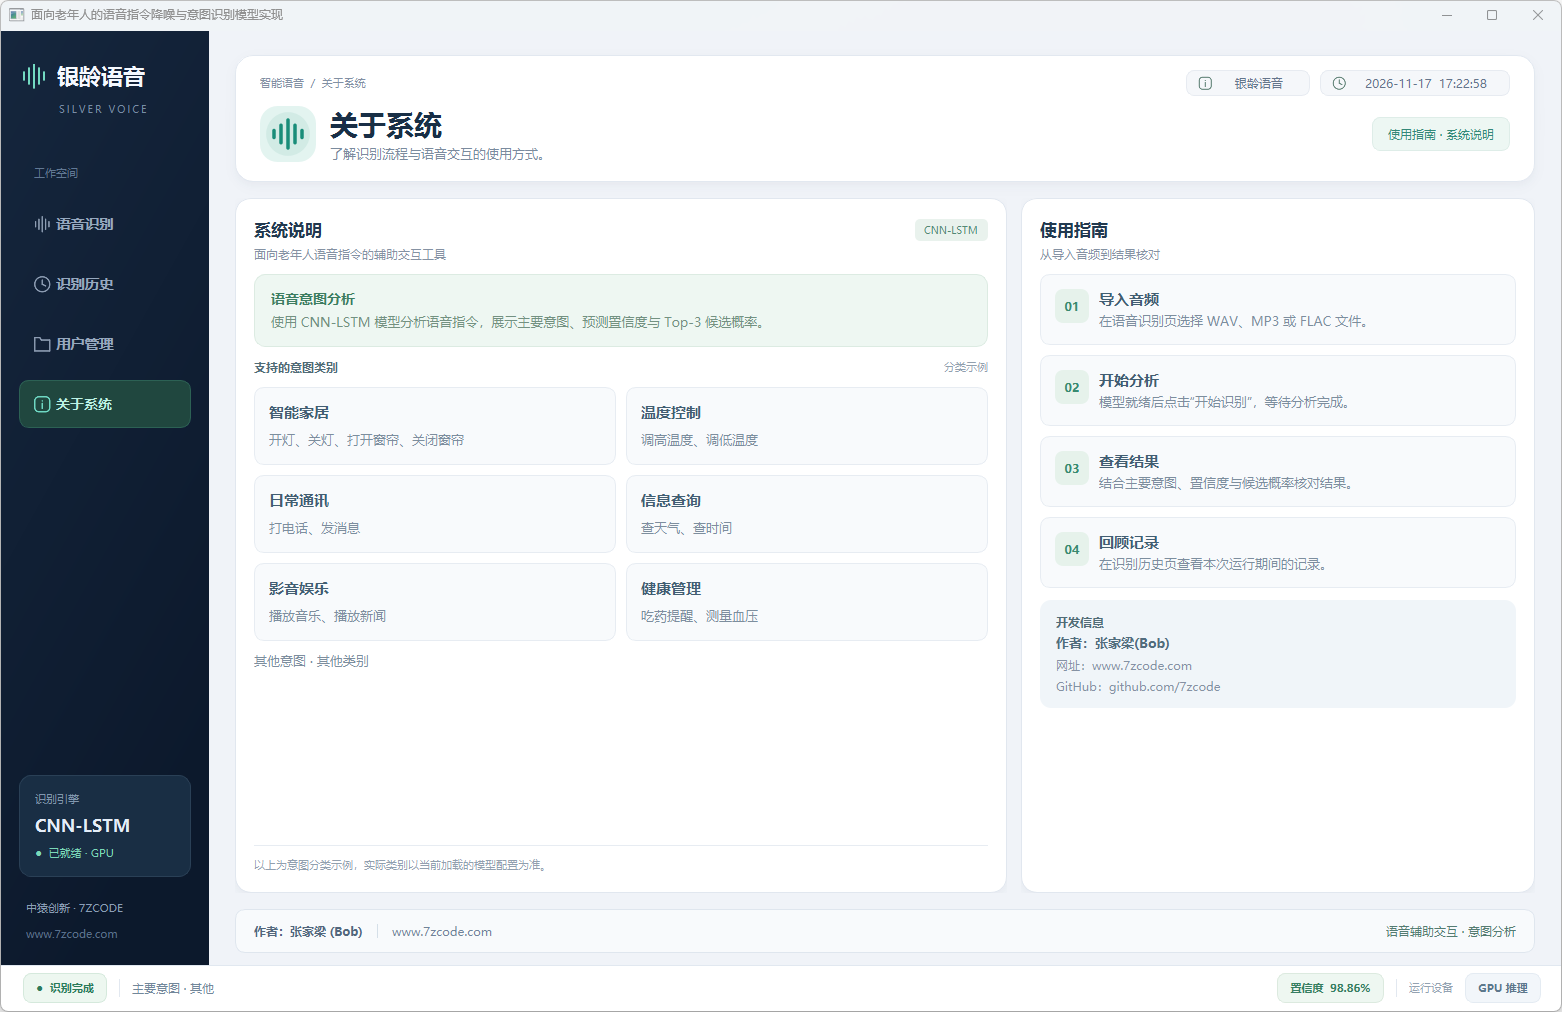
图25 关于系统
项目资源
配套文档
点击查看:面向老年人的语音指令降噪与意图识别模型实现 注意:收费提供!
配套文件
包括完整的项目源代码、演示视频、运行截图,开箱即用。
项目信息
作者信息
作者:Bob (张家梁)
项目编号:AI-92-P
原创声明:本项目为原创作品
联系方式
开源协议
本项目采用AGPL-3.0开源协议,允许个人和组织自由使用、修改和分发代码,但基于本项目的衍生作品必须同样开源,且用于提供网络服务时需向用户提供完整源代码。本项目仅供学习研究使用,作者不对使用本项目产生的任何后果承担责任,使用者应遵守当地法律法规,合理合法使用本项目。如本项目对您的研究或工作有所帮助,欢迎引用并注明出处。

评论(2)