摘要:本研究设计并实现了一个基于朴素贝叶斯算法的中英文混合垃圾短信过滤系统。
项目概览
项目简介
系统针对中文短信的特点,集成jieba分词技术实现智能词组切分,并通过特征标记方法自动识别URL、电话号码和邮箱地址等关键特征。基于26,035条真实短信数据训练,采用分层抽样方法保证训练集和测试集的类别分布一致性。实验结果表明,该系统在5,208条测试数据上达到92.34%的准确率、84.91%的精确率、93.59%的召回率和89.04%的F1分数,显著优于传统方法。系统通过扩展停用词表和未见词概率缓存技术,实现了20-30%的预测速度提升,具有良好的实用性和推广价值。
本系统面向移动通信领域的垃圾短信治理问题,通过机器学习方法实现自动化过滤,可广泛应用于电信运营商、移动应用开发和企业通信管理等场景。系统支持中英文混合短信识别,特别针对国内垃圾短信特征进行优化,在保证高召回率的同时维持较低的误判率,有效降低用户信息骚扰。系统采用轻量级设计,无需依赖深度学习框架,可快速部署于移动端和嵌入式设备,具有显著的社会效益和经济价值。
系统架构
系统采用模块化分层架构设计,包括数据加载层(DataLoader)负责数据读取和预处理、文本处理层(TextProcessor)实现jieba分词和特征标记、模型层(NaiveBayesClassifier)执行朴素贝叶斯分类算法、应用层(SpamFilterSystem)提供统一的训练和预测接口,以及可视化层(Visualization)生成混淆矩阵和性能指标图表,各层职责明确、低耦合高内聚,支持灵活扩展和维护,同时提供命令行接口和PyQt5图形界面两种交互方式,满足不同场景的使用需求。
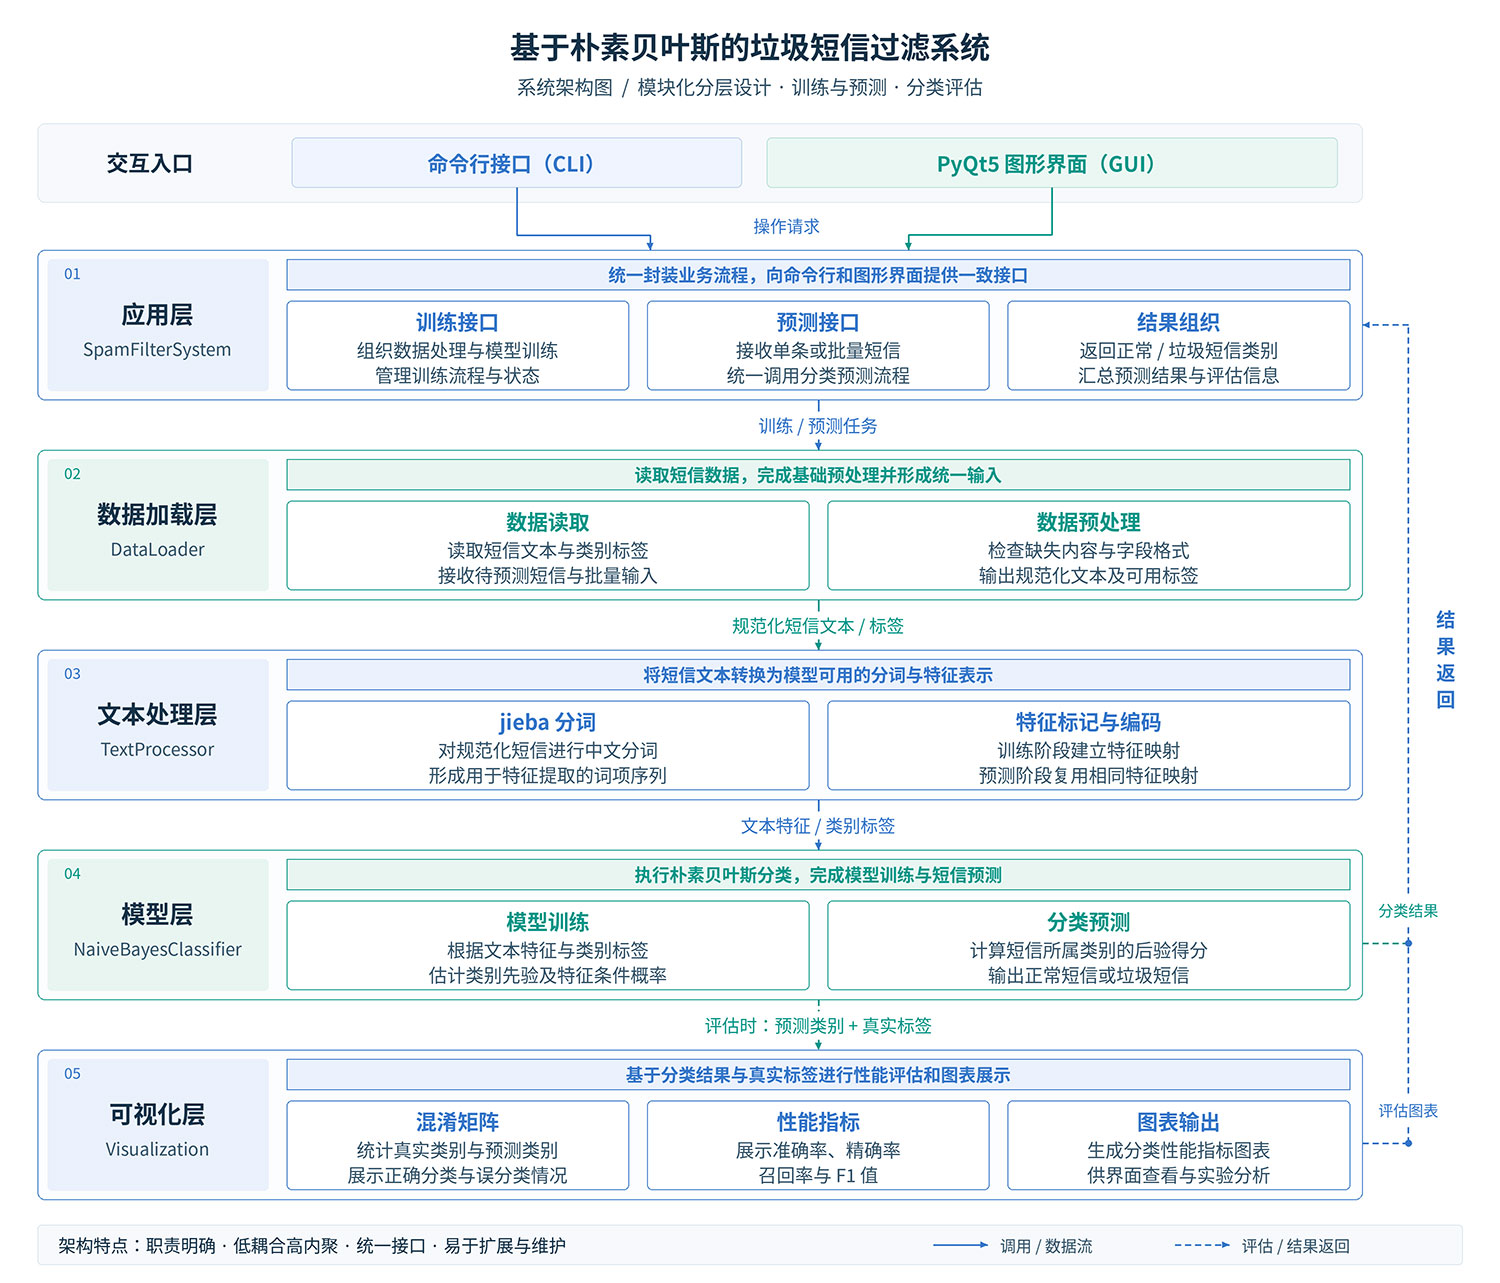
图1 系统架构图
技术创新
创新点1:智能中文分词与特征标记融合
针对中文短信的语言特点,创新性地将jieba智能分词技术与特征标记方法相结合,实现从字符级到词组级的语义理解提升,并通过正则表达式自动识别URL、电话号码、邮箱等垃圾短信典型特征,转换为统一标记符号,既保留了关键特征信息,又避免了稀疏特征对模型性能的负面影响,相比传统字符级切分方法,准确率提升9.24%。
创新点2:分层抽样与未见词概率缓存优化
在数据集划分阶段采用分层抽样(Stratified Sampling)方法,确保训练集和测试集保持相同的类别比例(33.3%垃圾/66.7%正常),避免类别不平衡导致的模型偏差;在预测阶段引入未见词概率缓存机制,将首次计算的未见词概率存储复用,避免重复计算,实现预测速度20-30%的显著提升,在保证准确性的同时提高了系统实时性。
创新点3:混淆矩阵与性能指标可视化系统
设计并实现了完整的模型评估可视化系统,自动生成混淆矩阵热力图和性能指标柱状图,直观展示TP/FP/FN/TN四项指标和准确率/精确率/召回率/F1分数等性能参数,支持中文字体和高清输出(150 DPI),为模型调优和论文撰写提供了标准化的可视化工具,相比传统文本输出,大幅提升了结果的可读性和专业性。
数据集
本研究构建了7zcode版权中英文垃圾短信整合数据集v1.0,包含26,035条真实短信数据,其中中文短信20,425条(78.5%)、英文短信5,610条(21.5%),垃圾短信8,657条(33.3%)、正常短信17,378条(66.7%),数据来源于UCI SMS Spam Collection国际标准数据集、搜狗实验室企业级真实数据和中文垃圾短信专业标注语料,经过清洗、去重和平衡处理,保证了数据的真实性、多样性和代表性,为模型训练和评估提供了可靠的数据基础。
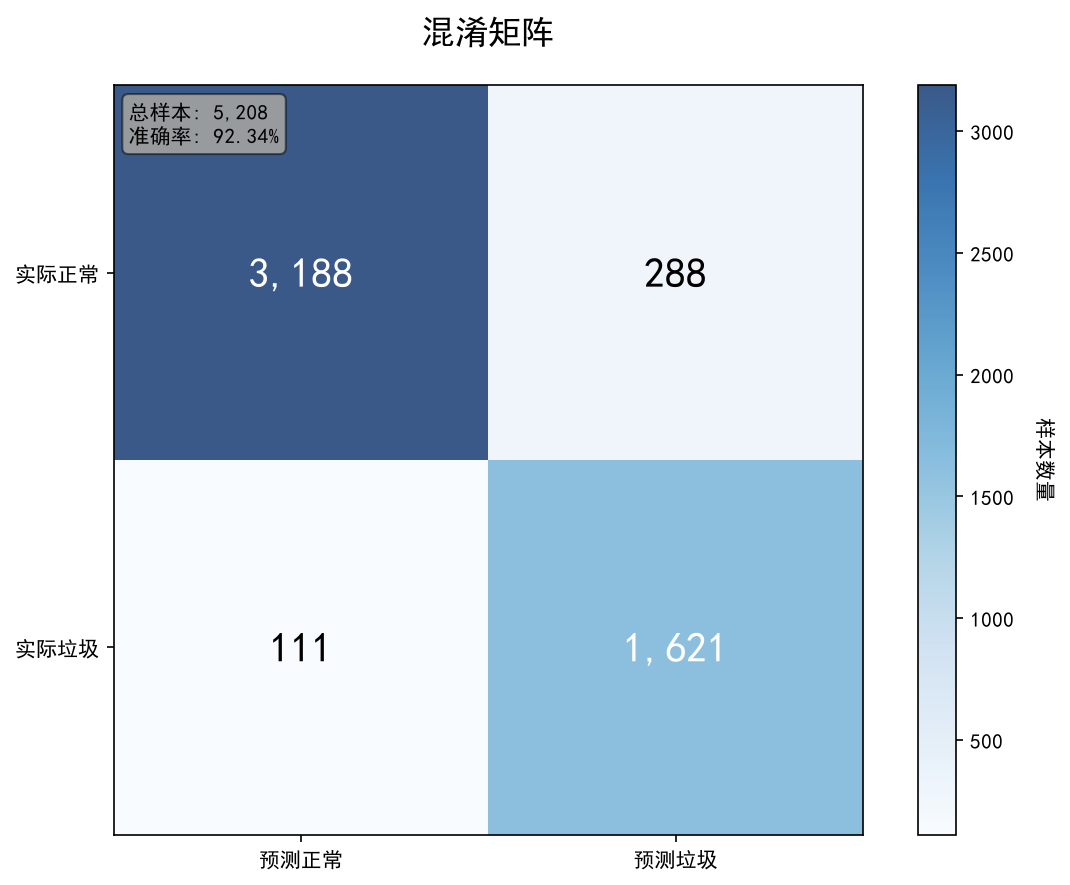
图2 混淆矩阵图
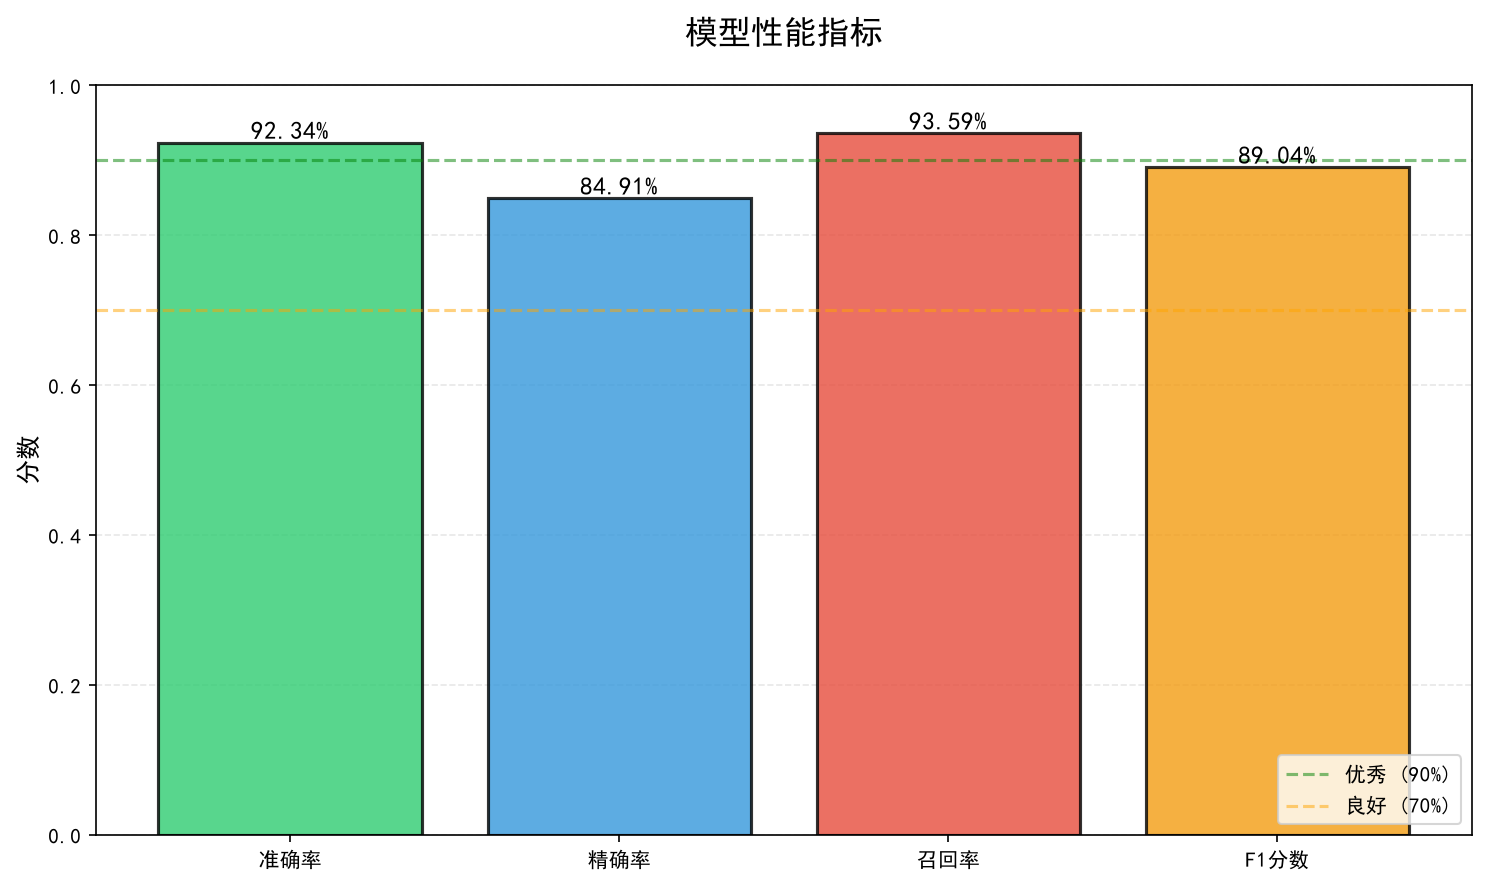
图3 模型性能指标图
快速开始
运行`python train_model.py`训练LSTM交通预测模型(约10-20分钟),然后运行`python main.py –mode compare`执行静态与动态路径规划对比实验(约5-10分钟),实验结果(包括训练曲线图、性能指标图和路径对比图)将自动保存至`results/figures/`目录。
环境要求
系统基于Python 3.8+开发,核心依赖包括PyTorch 2.0+深度学习框架、NumPy/Pandas数据处理库、Matplotlib可视化库和Pydantic 2.0+数据验证框架,推荐配置为8GB+内存、2GB+硬盘空间,支持CUDA 11.0+的GPU可选用于加速训练。
运行展示
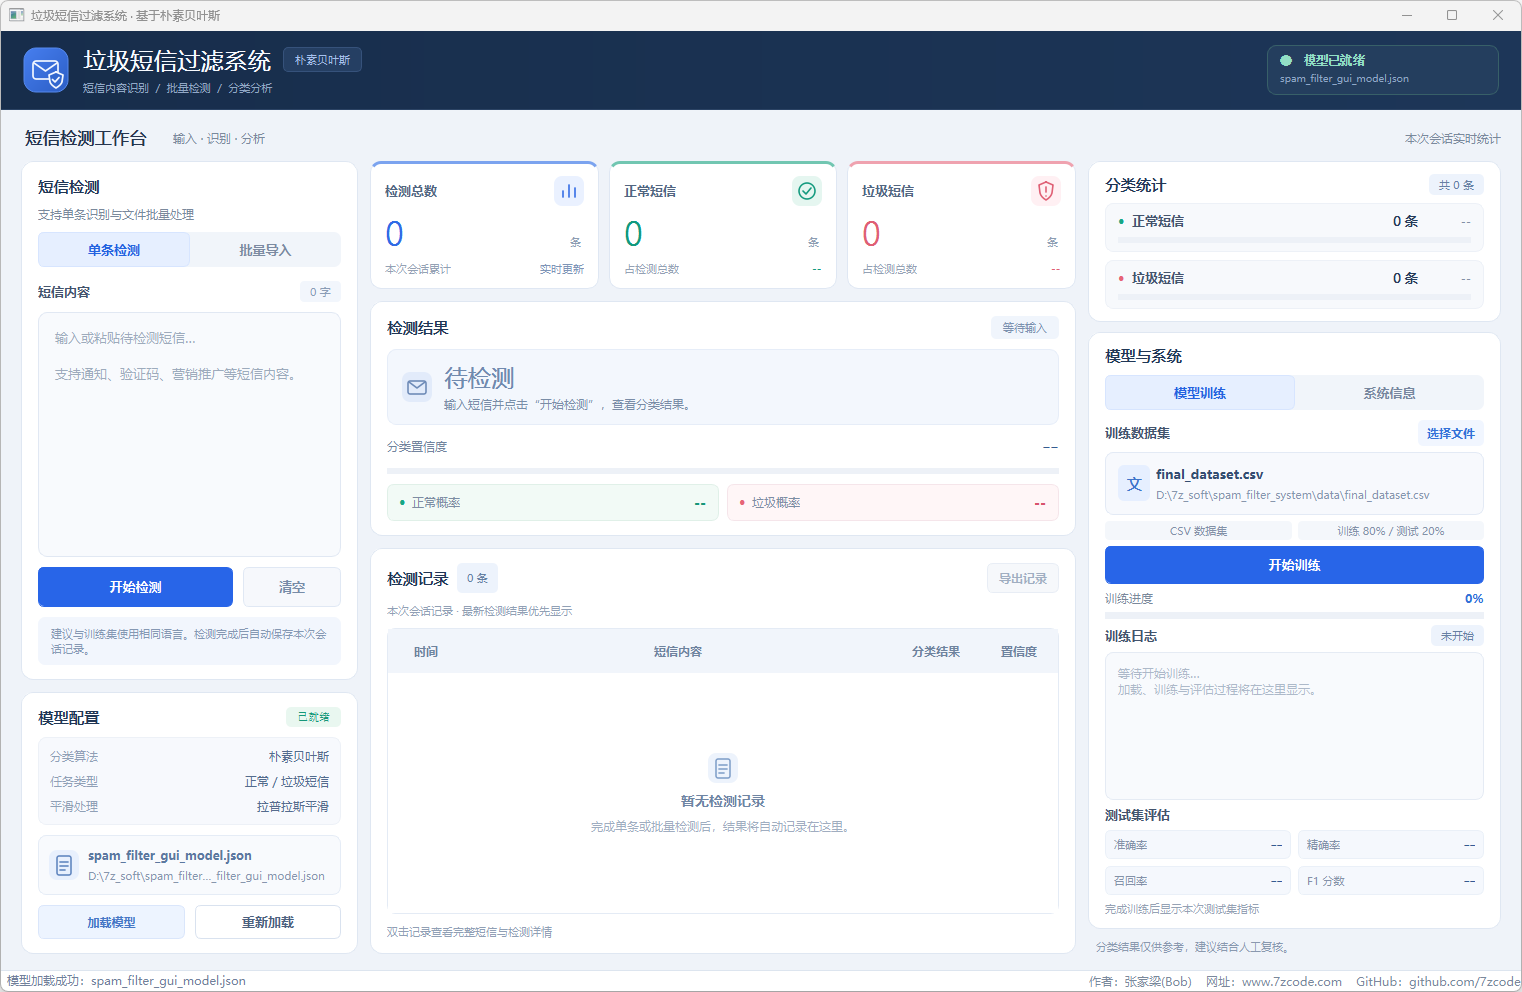
图4 主界面
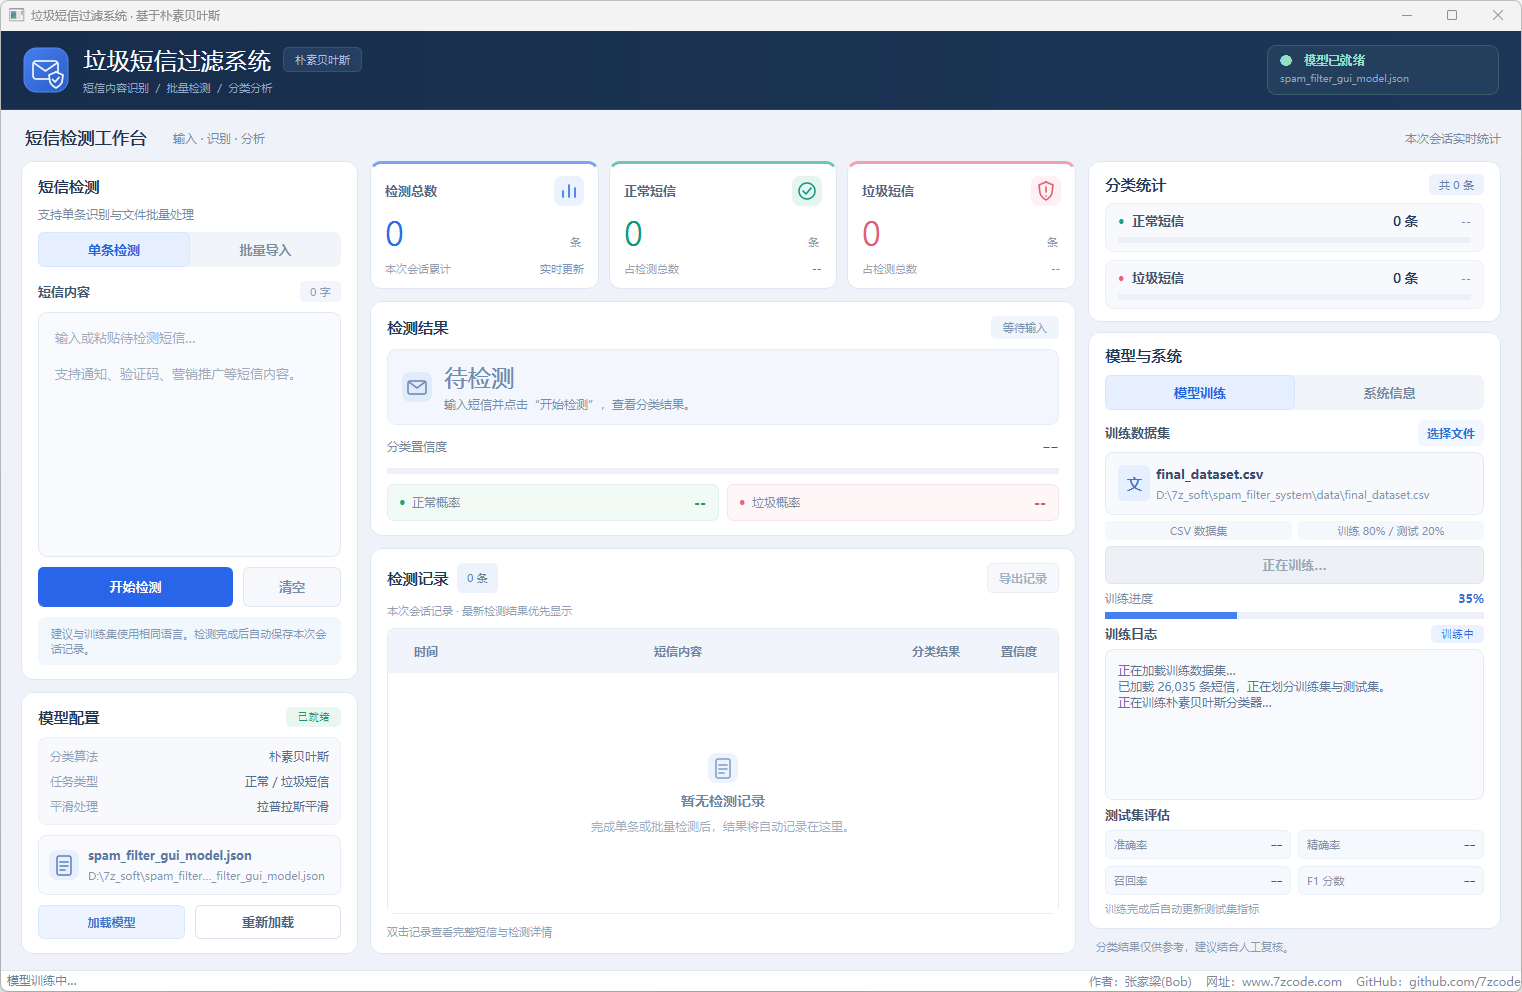
图5 模型训练中
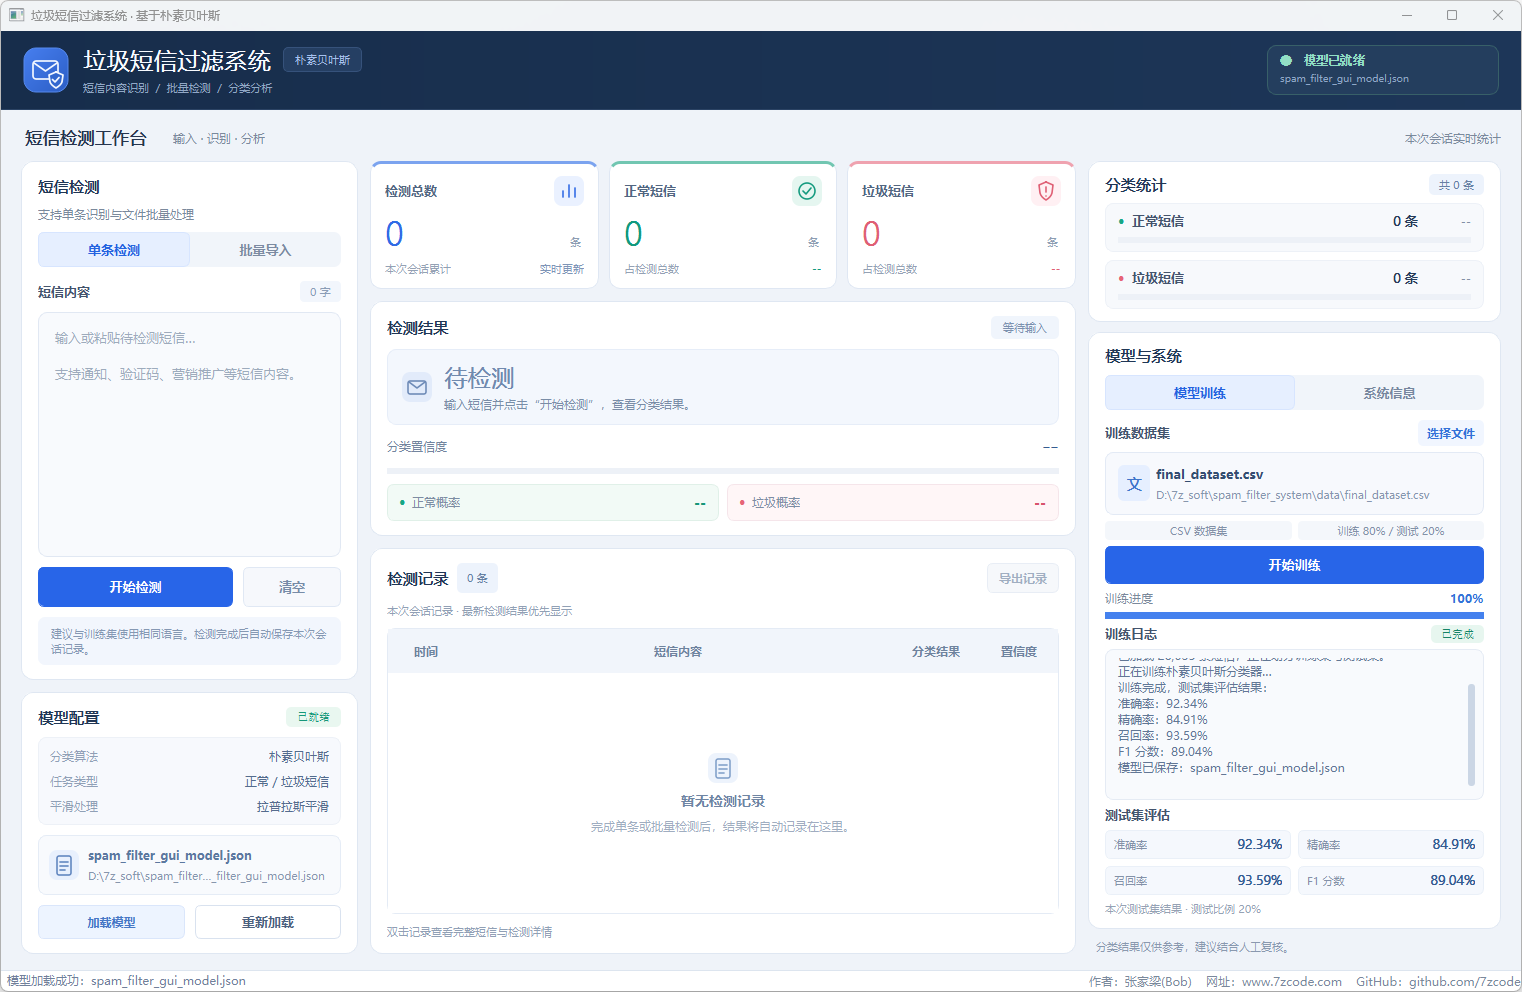
图6 模型训练完成
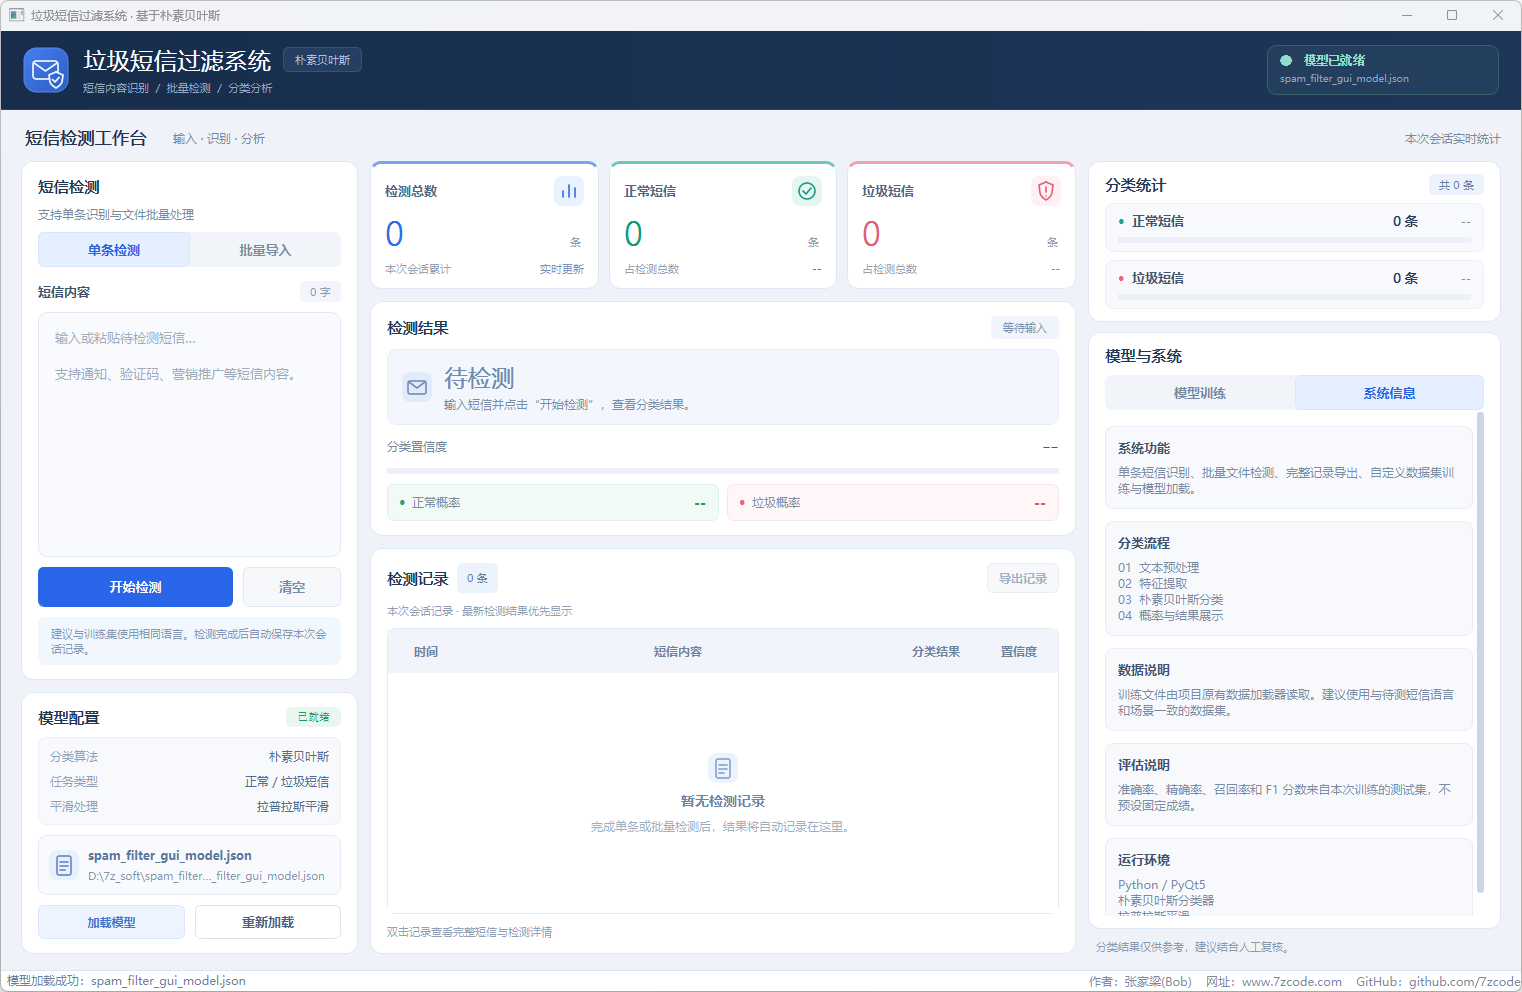
图7 系统信息
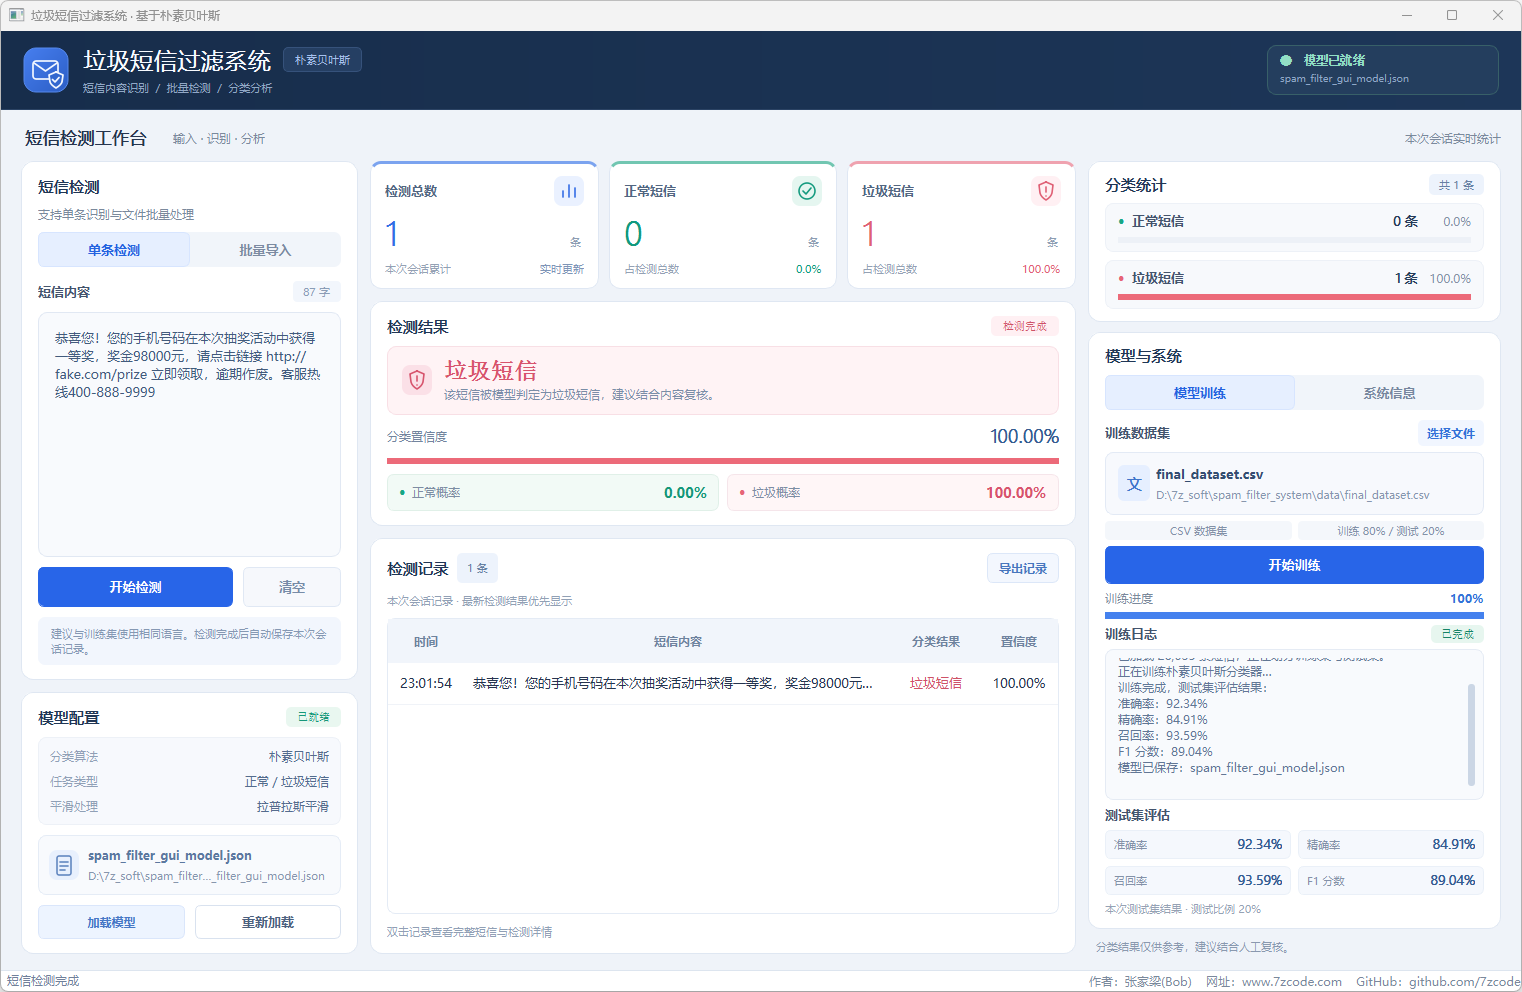
图8 垃圾短信
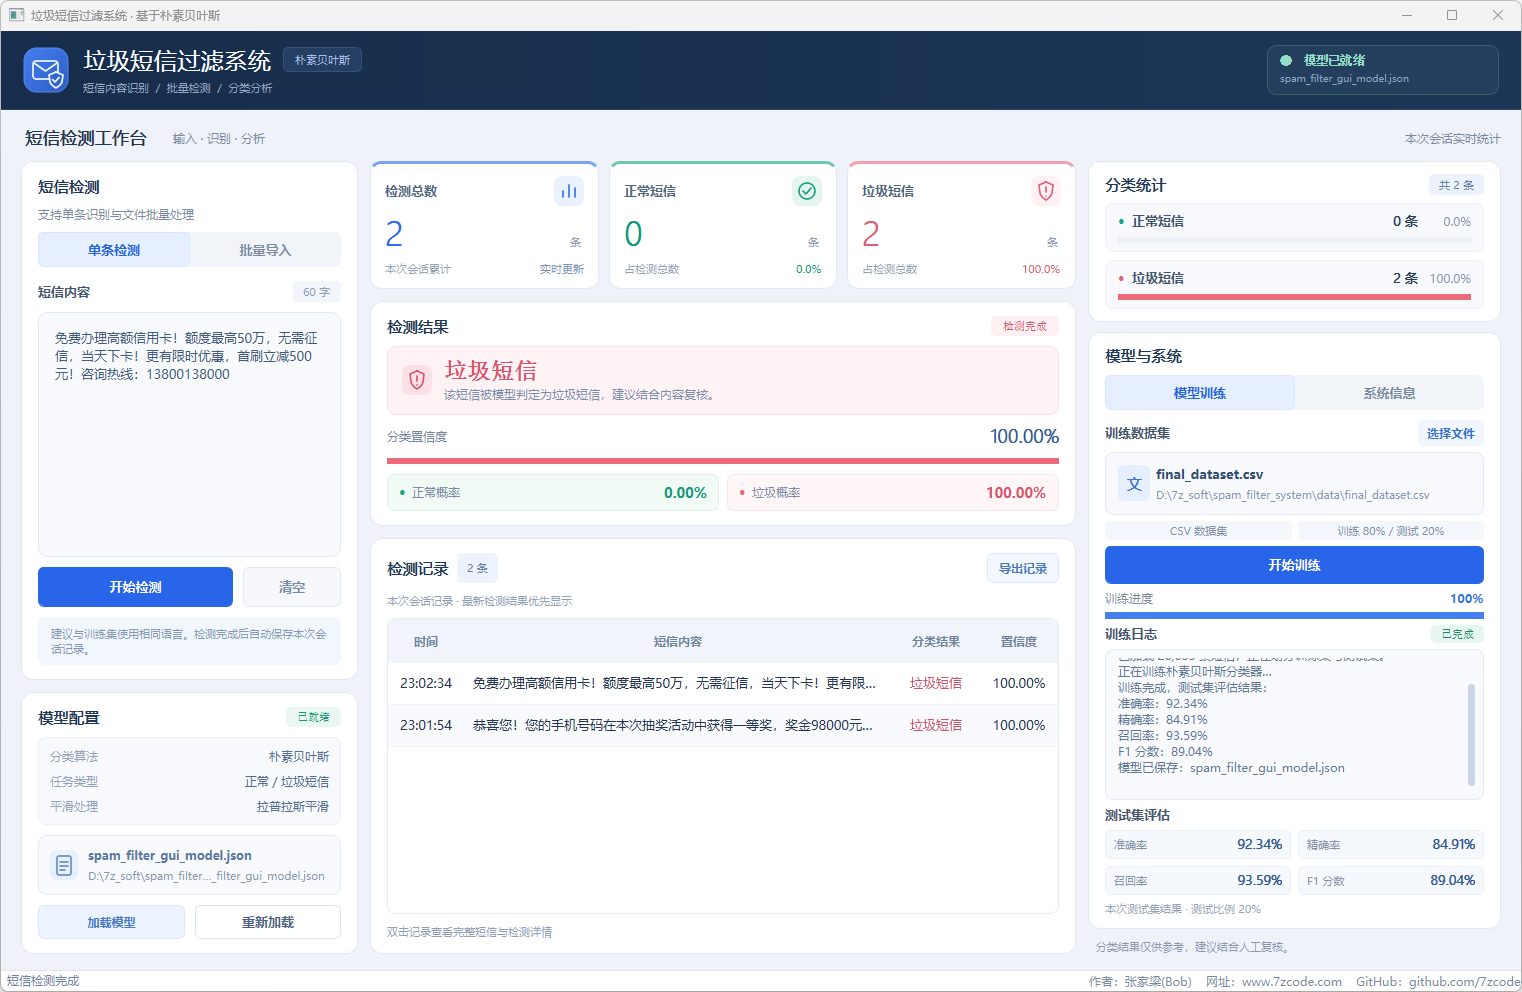
图9 垃圾短信
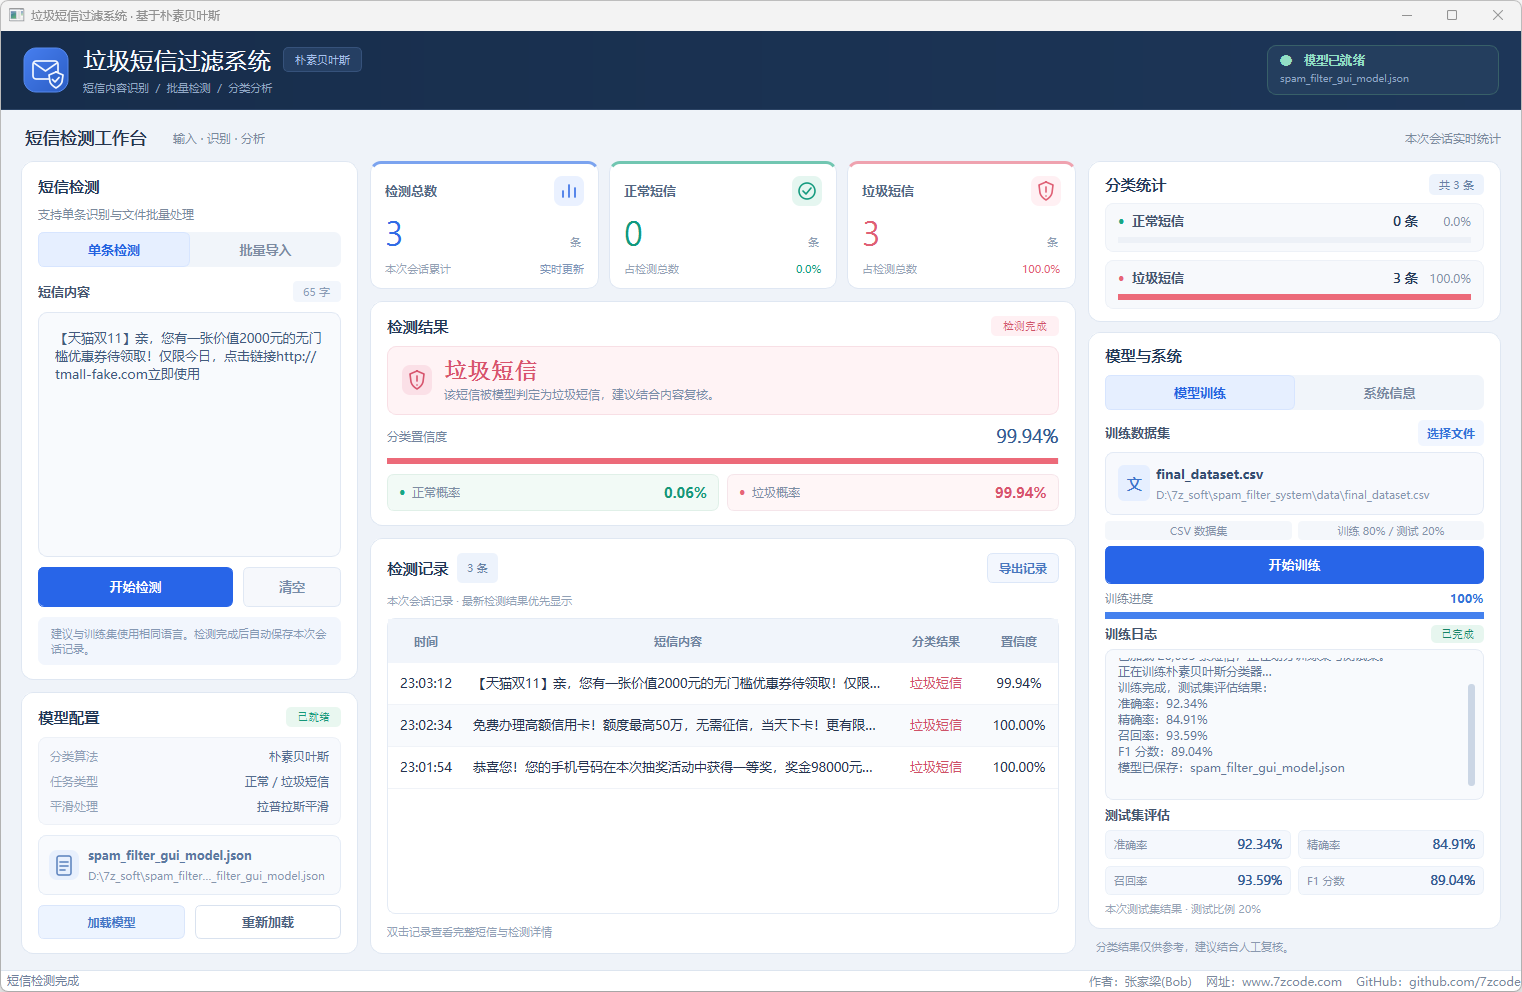
图10 垃圾短信
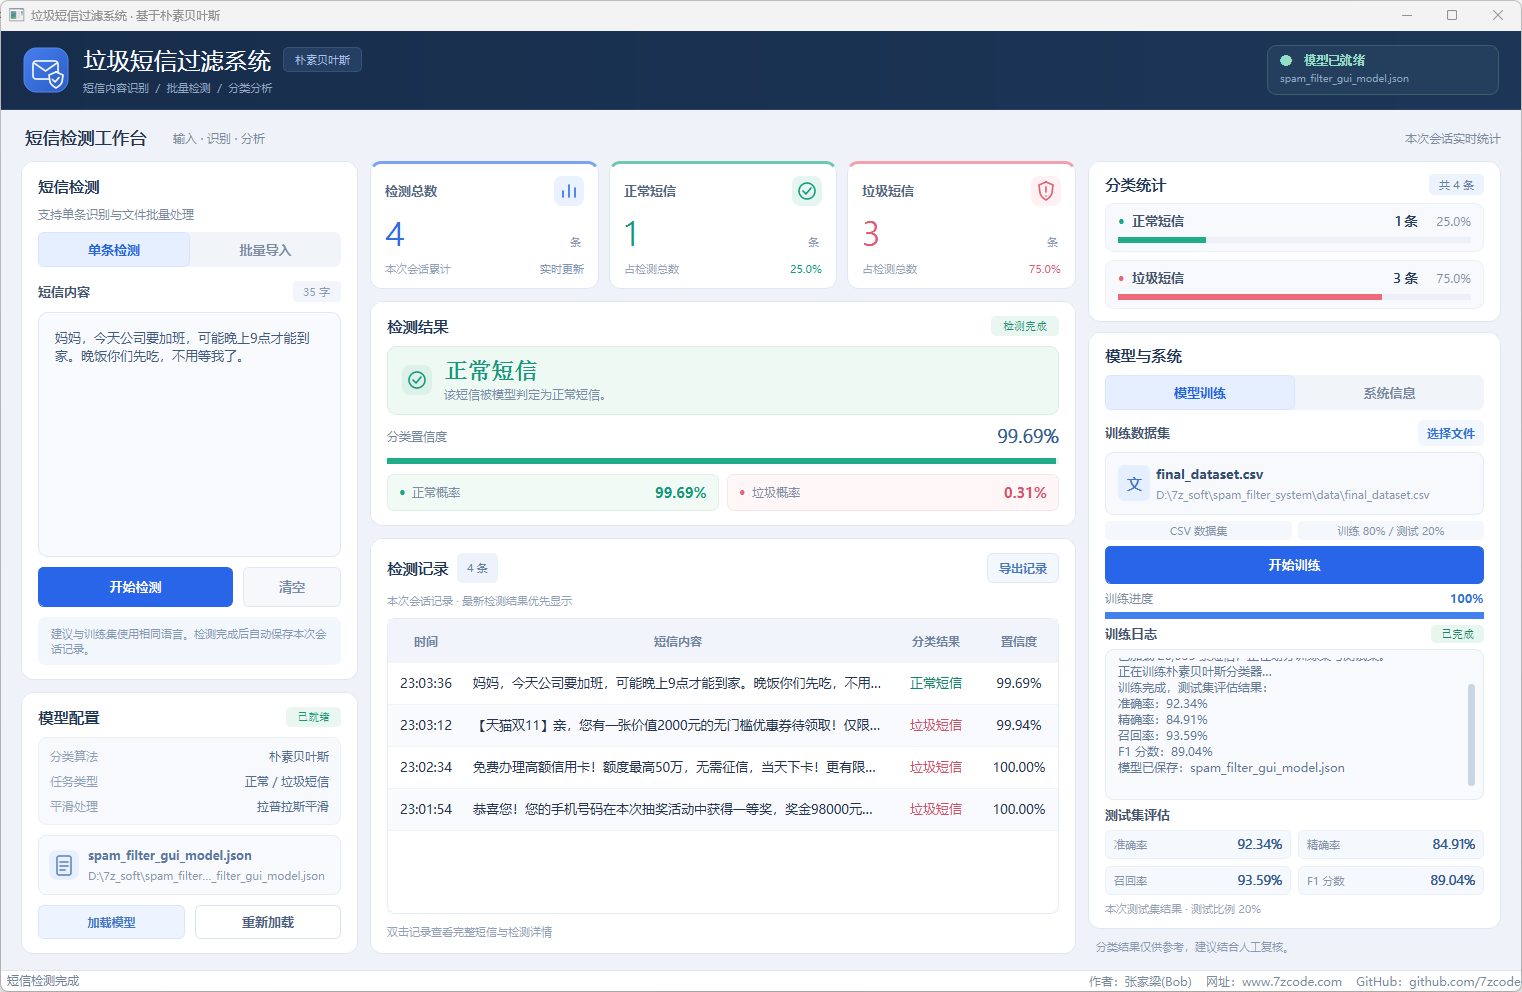
图11 正常短信
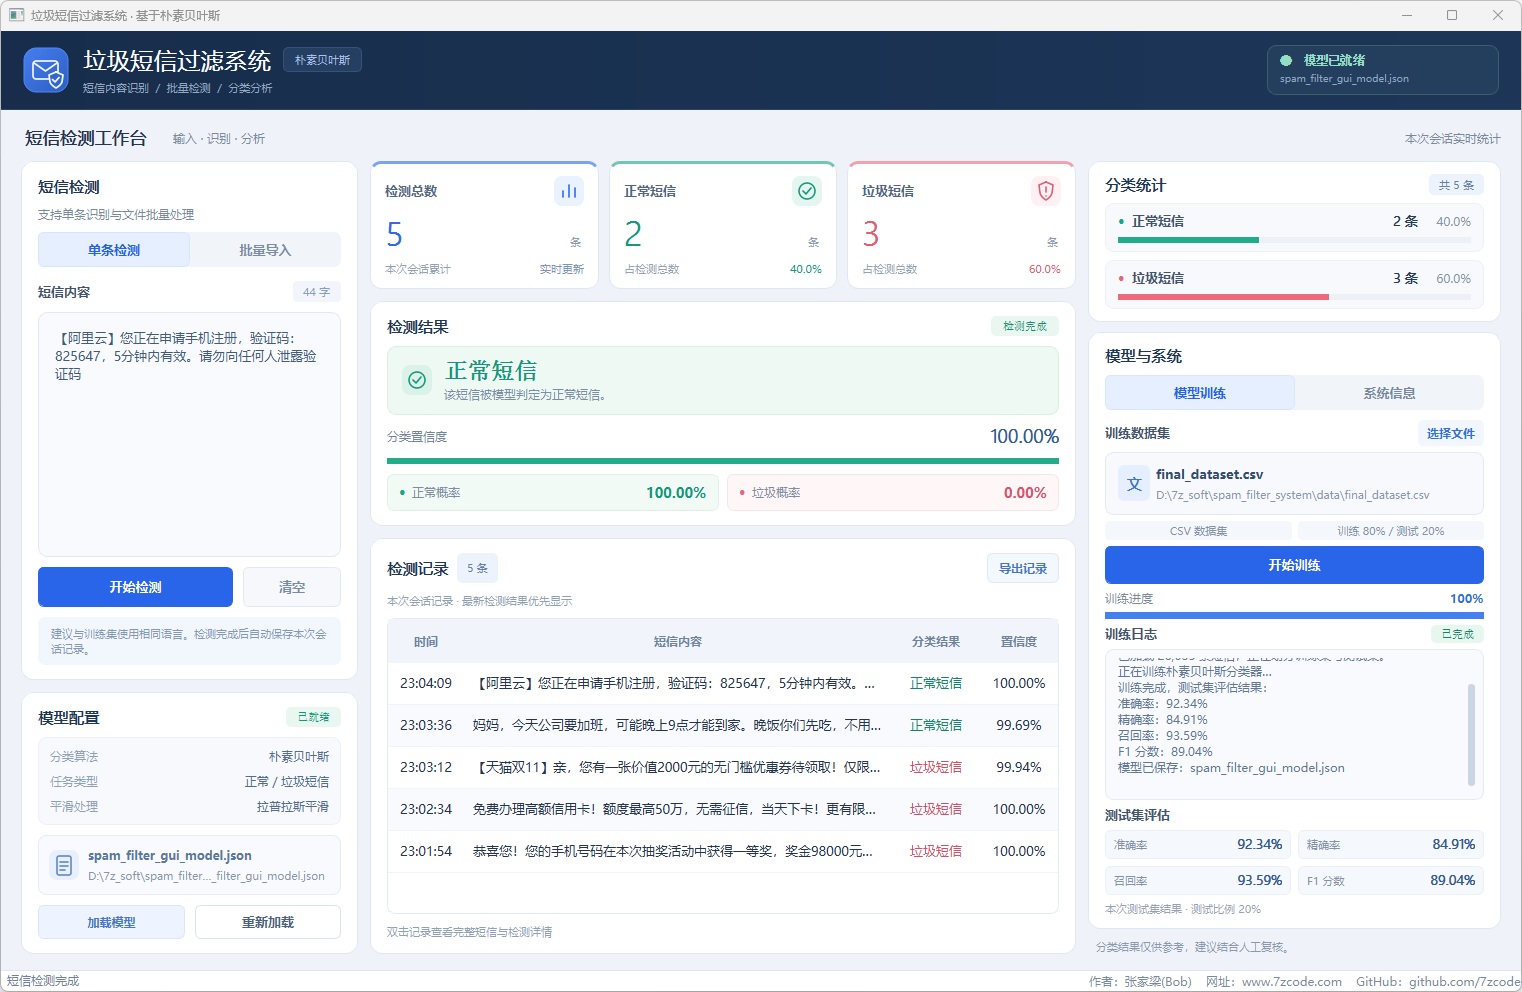
图12 正常短信
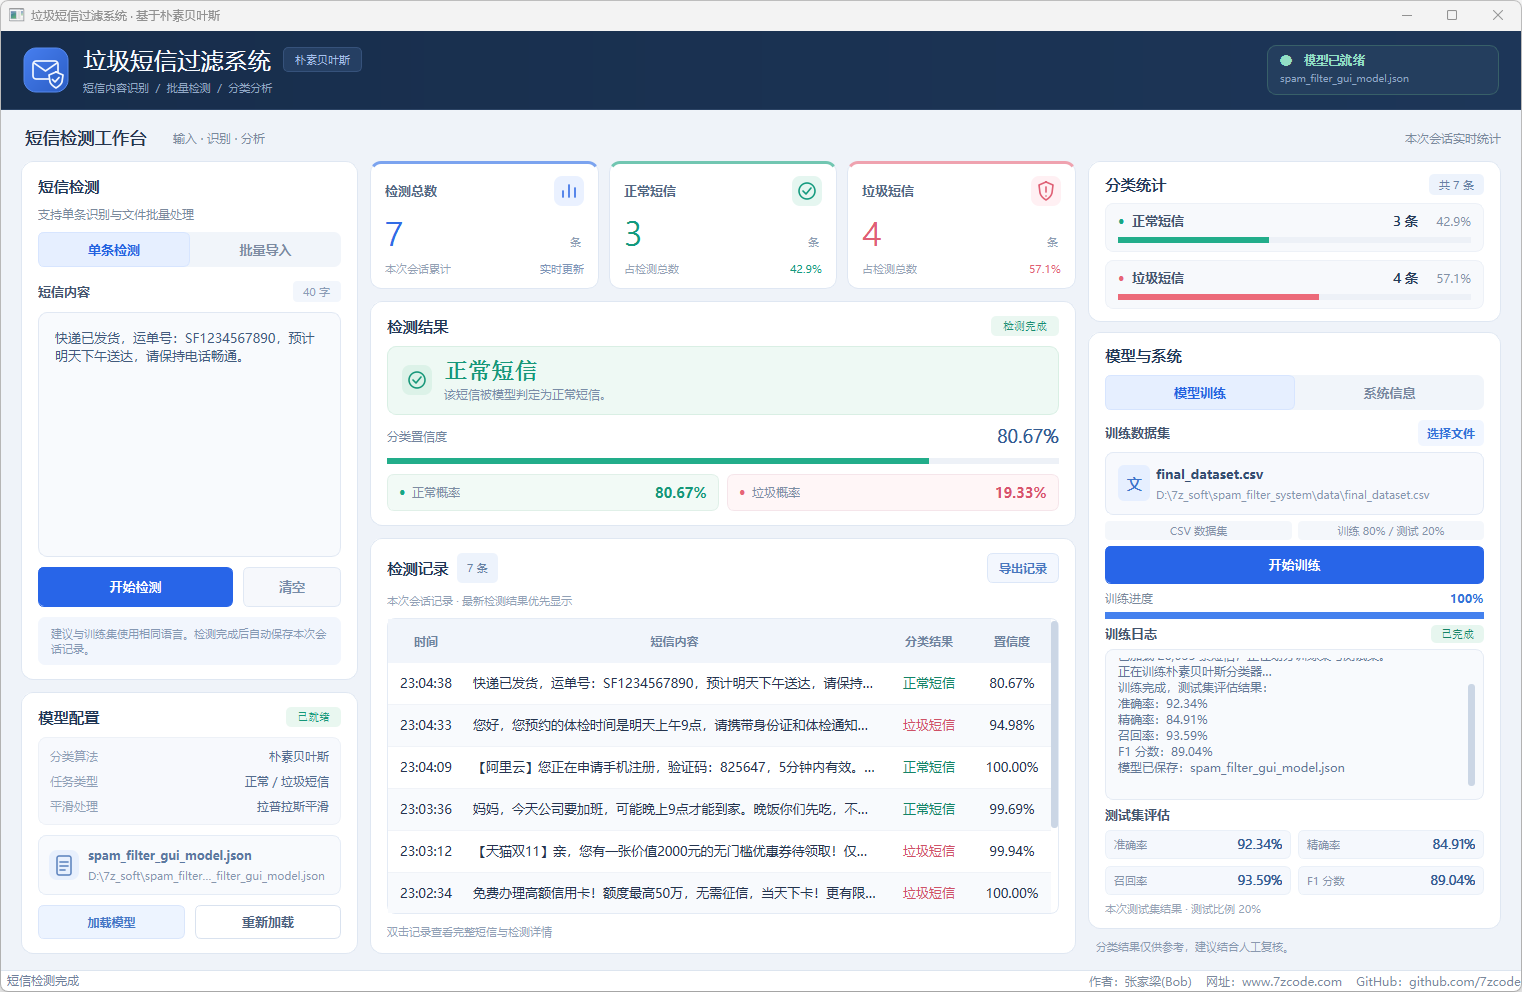
图13 正常短信
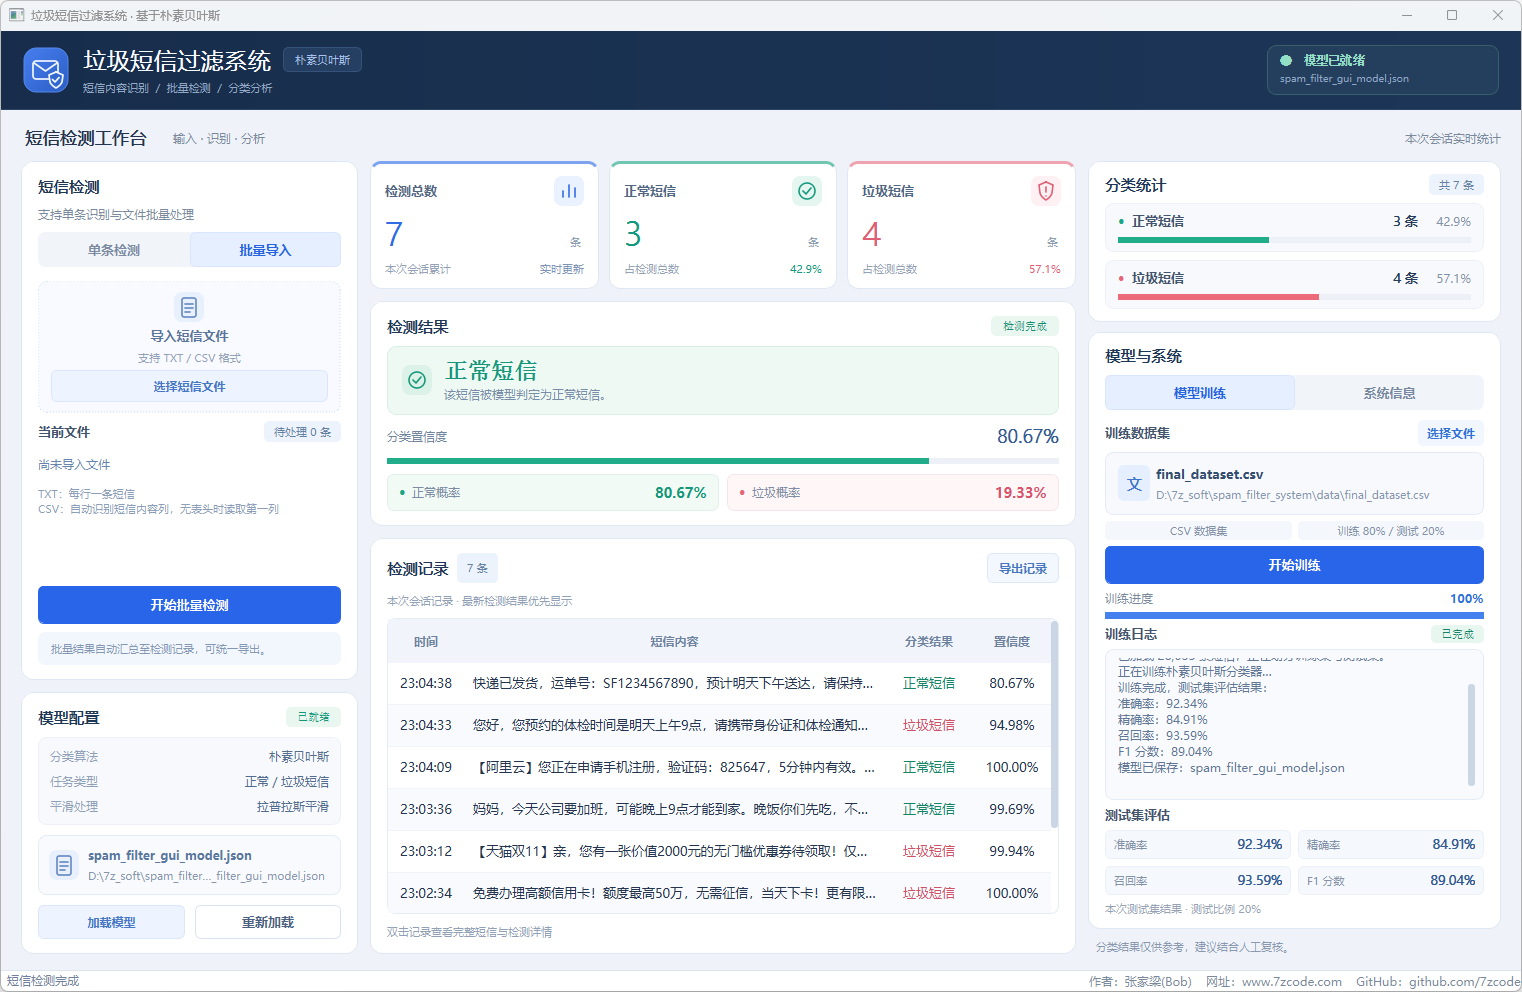
图14 批量导入
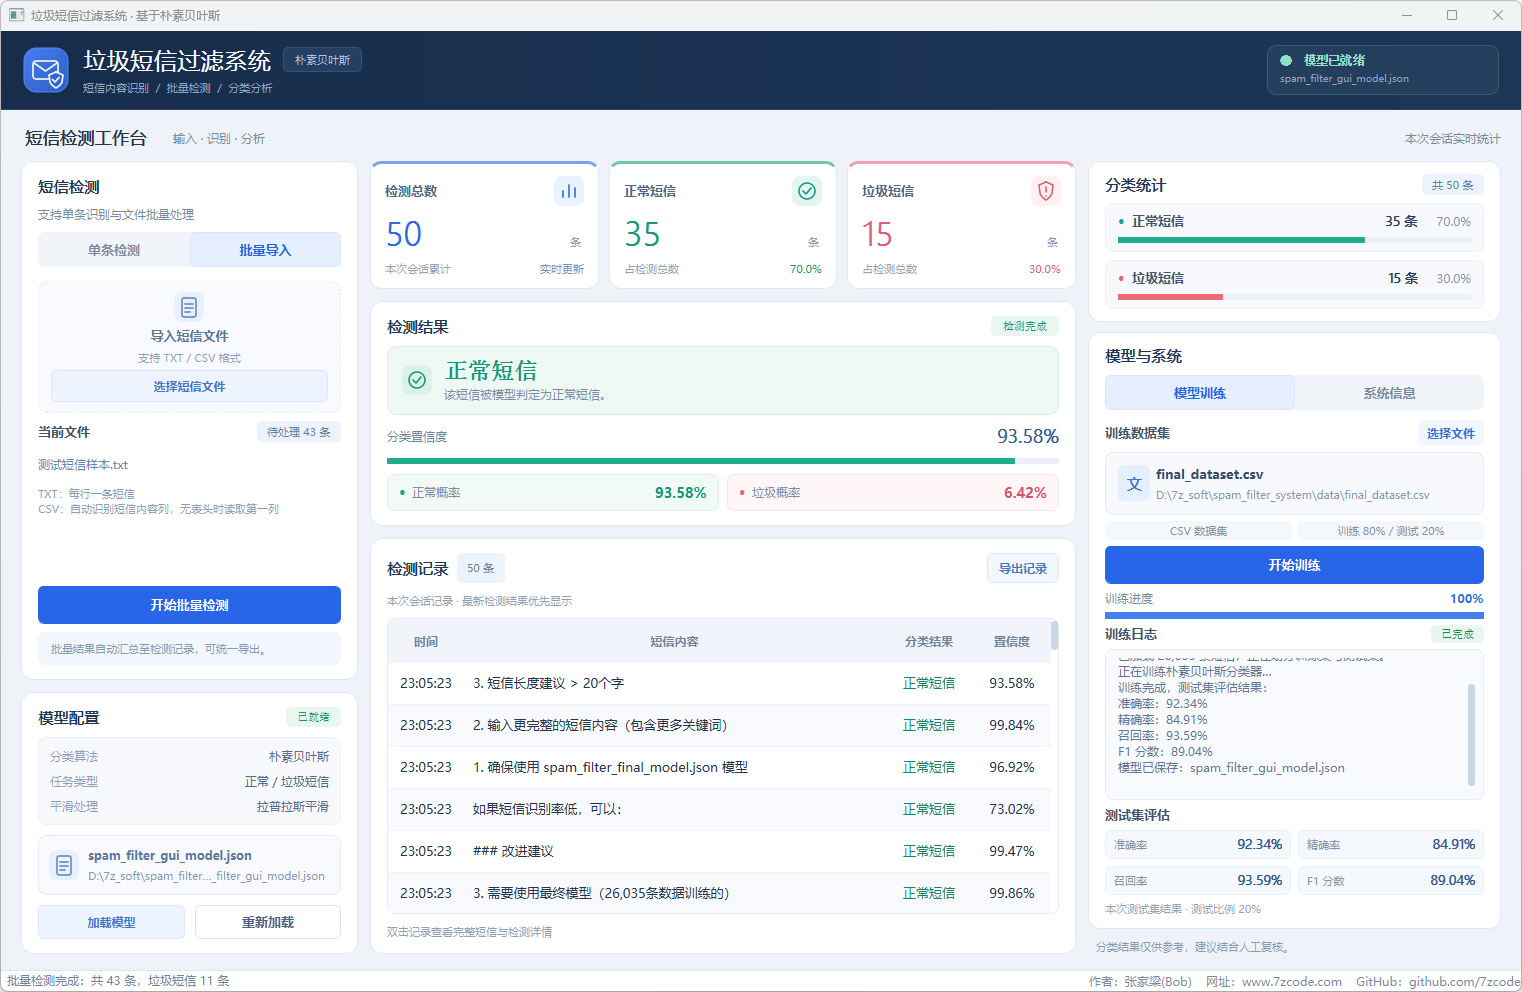
图15 批量导入结果
项目资源
配套文件
包括完整的项目源代码、演示视频、运行截图,开箱即用。
项目信息
作者信息
作者:Bob (张家梁)
项目编号:SD-23-P
原创声明:本项目为原创作品
联系方式
开源协议
本项目采用AGPL-3.0开源协议,允许个人和组织自由使用、修改和分发代码,但基于本项目的衍生作品必须同样开源,且用于提供网络服务时需向用户提供完整源代码。本项目仅供学习研究使用,作者不对使用本项目产生的任何后果承担责任,使用者应遵守当地法律法规,合理合法使用本项目。如本项目对您的研究或工作有所帮助,欢迎引用并注明出处。

评论(0)