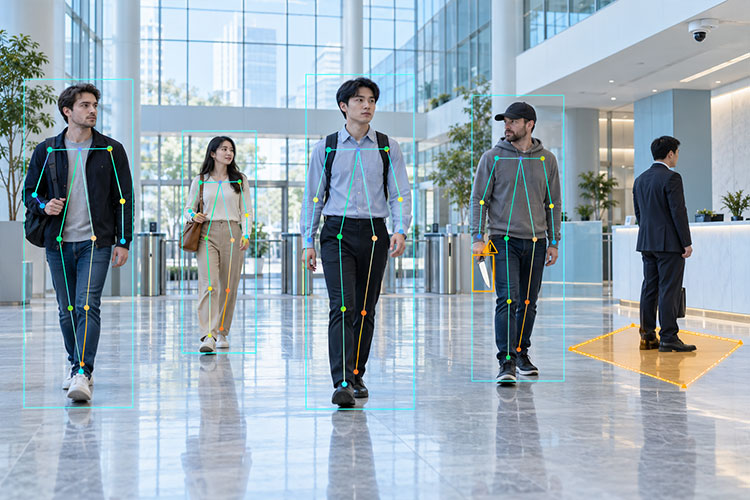
摘要:针对传统安防视频依赖人工值守、单一目标检测无法刻画复杂行为以及不同场景下预警规则难以灵活配置的问题,本文围绕本地视频分析应用,研究并实现一种基于YOLO26n目标检测与MediaPipe人体姿态估计的智能安防系统。系统将目标外观、人体关键点、跨帧轨迹与场景区域信息进行联合分析,完成危险物品、疑似打斗、徘徊停留、遗留物品和区域入侵等事件的识别与告警。
内容简介
系统采用数据采集、智能分析和应用展示三层结构。数据采集层基于OpenCV完成MP4、AVI、MOV、MKV等本地视频的读取、解码及帧序列组织;智能分析层利用YOLO26n获取人员和物品目标框,借助MediaPipe提取人体姿态关键点,结合目标关联、运动轨迹、时间窗口与多边形区域判定完成威胁事件决策;应用展示层采用PyQt5实现中文三栏桌面工作台,支持视频预览、参数设置、交互式警戒区域绘制、风险统计、预警记录和报告导出。通过工作线程与图形界面解耦,避免深度模型推理阻塞交互操作。
基于系统运行截图可以核实其已经完成模型加载、危险物品识别、遗留物品提示、区域配置、入侵提示和徘徊停留提醒等主要功能。在展示片段中,系统处理速度约为8.1~21.5 FPS;该数值为特定运行时刻的界面读数,不能替代统一硬件、同一视频集条件下的基准测试。论文进一步给出检测准确性、误报与漏报、端到端时延和资源占用等指标的实验设计,并区分已有运行证据与后续需要补充的统计结果。研究表明,轻量化目标检测与姿态、轨迹及几何规则相结合能够构成具有可解释性、可配置性和可扩展性的本地视频安防原型。
文档概述
文档信息
版本:初稿
页数:35页
字数:16708个字
格式:word(可编辑)
图表:11张图、4张表、9个公式
文档目录
摘 要 2
Abstract 3
目 录 4
第1章 绪论 1
1.1 研究背景与意义 1
1.2 国内外研究现状 1
1.3 主要研究内容 2
1.4 论文组织结构 2
第2章 相关理论与关键技术 3
2.1 卷积神经网络与特征学习 3
2.2 YOLO26n模型与检测机理 3
2.3 姿态估计与MediaPipe 4
2.4 多目标跟踪与时序状态 4
2.5 评价指标与误差来源 4
2.6 本章小结 5
第3章 系统需求分析与总体设计 6
3.1 系统应用场景与功能需求 6
3.2 非功能需求与约束 6
3.3 系统总体架构 7
3.4 数据流与线程协同 8
3.5 可视化交互与预警管理 9
3.6 程序流程与异常处理 9
3.7 本章小结 10
第4章 目标检测与姿态融合威胁识别算法设计 12
4.1 YOLO26n检测模块设计 12
4.2 关键点坐标与姿态特征 12
4.3 危险物品检测与持物关联 13
4.4 疑似打斗行为识别 13
4.5 徘徊停留检测 14
4.6 遗留物品分析 14
4.7 多边形区域入侵算法 15
4.8 融合决策与预警去重 15
4.9 本章小结 16
第5章 系统实现、实验与结果分析 17
5.1 开发环境与实现方案 17
5.2 模型初始化与界面状态 17
5.3 危险物品识别功能测试 19
5.4 正常场景与遗留物品测试 20
5.5 自定义警戒区域与入侵识别 22
5.6 徘徊停留识别演示 23
5.7 实验设计与评价方法 24
5.8 运行截图的定量整理 25
5.9 功能覆盖与误报风险讨论 26
5.10 本章小结 26
第6章 总结与展望 27
6.1 研究工作总结 27
6.2 研究局限性 27
6.3 后续改进方向 27
6.4 本章小结 28
参考文献 28
致 谢 29
附录A 实验复现与资料核验清单 29
配套项目
作者联系
作者信息
原创作者:bob(可提供二次开发有偿修改服务)
项目编号:AI-62-P
原创声明:本项目为原创作品
联系方式
开源协议
本项目采用AGPL-3.0开源协议,允许个人和组织自由使用、修改和分发代码,但基于本项目的衍生作品必须同样开源,且用于提供网络服务时需向用户提供完整源代码。本项目仅供学习研究使用,作者不对使用本项目产生的任何后果承担责任,使用者应遵守当地法律法规,合理合法使用本项目。如本项目对您的研究或工作有所帮助,欢迎引用并注明出处。

评论(2)