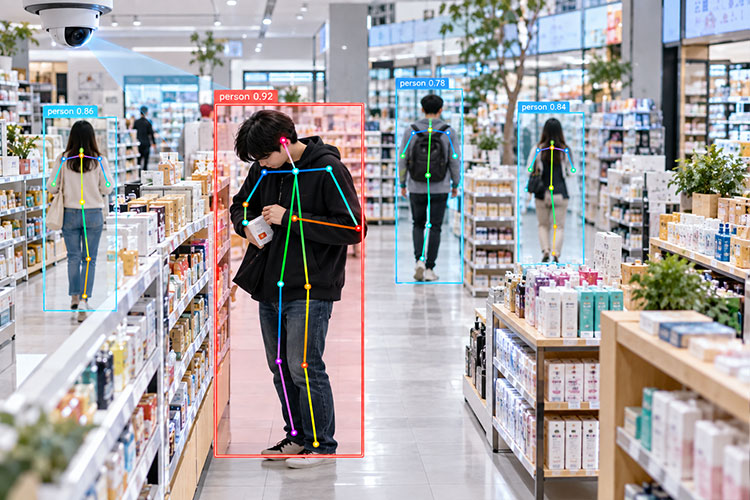
摘要:随着零售业数字化转型和门店视频监控系统的普及,依赖人工持续观察监控画面的传统防损方式逐渐暴露出工作强度大、主观性强、响应滞后以及人力成本高等问题。盗窃行为通常伴随伸手拿取、靠近躯干、藏匿商品、弯腰遮挡等具有一定姿态规律的动作,因此利用人体姿态信息构建轻量级行为识别模型,能够在不直接依赖商品外观和人脸身份信息的条件下,为零售安全监控提供实时风险提示。
内容简介
围绕这一需求,本文设计并实现了一套基于YOLO姿态估计和XGBoost的零售店铺盗窃行为实时检测系统。系统采用“视频采集—姿态估计—特征提取—行为分类—结果展示”的分层处理流程,使用YOLOv11s-Pose从视频帧中检测人体并提取COCO标准的17个人体关键点,在人体边界框内对关键点二维坐标进行归一化,构建34维姿态特征向量,再将特征输入XGBoost分类器完成NORMAL正常行为与SUSPICIOUS可疑行为的二分类判断。
本研究按照既定训练流程构建了由183个视频组成的数据资源,其中包括90个正常行为视频和93个盗窃行为视频,经批量关键点提取、自动标注和质量过滤后形成318847条帧级姿态样本。由于训练阶段对盗窃视频采用更高的采样密度,最终帧级样本呈现约12:1的类别不平衡。针对该问题,本文利用XGBoost的scale_pos_weight参数进行代价敏感学习,并通过对比实验选择8.0作为平衡模式的类别权重。在该设置下,系统整体准确率达到87.14%,可疑行为检出率达到89.79%,正常行为识别率达到55.68%,相较未进行权重平衡的基线方案,正常样本误报数量由4632降至2196,误报约减少53%。系统同时保留安全优先、平衡和体验优先三种配置思路,以适应高价值商品区域、一般营业时段和高客流场景对漏检与误报的不同容忍度。
在工程实现方面,系统基于Python、OpenCV、Ultralytics YOLO、XGBoost和PyQt5构建图形化操作界面,支持视频文件选择、YOLO姿态模型选择、XGBoost分类模型加载、置信度与分类阈值配置、处理进度显示、实时统计、运行日志以及标注视频保存等功能。测试结果表明,YOLO姿态估计约占主要计算开销,XGBoost单次分类耗时低于1 ms,系统单帧处理时间约80 ms,端到端延迟约150 ms,可达到约12~15 FPS的实时分析速度;YOLOv11s-Pose与XGBoost模型总体积约20 MB,具有较好的轻量化部署能力。
研究结果说明,采用“深度姿态估计+传统集成学习”的双模型协同方式,可以在模型规模、实时性、可解释性和识别性能之间取得较为实用的平衡。需要强调的是,系统输出仅表示行为风险等级,不能直接作为盗窃事实认定依据,实际应用仍需结合人工复核和门店管理规则。
文档概述
文档信息
版本:初稿
页数:53页
字数:22241个字
格式:word(可编辑)
图表:12张图、17张表、18个公式
文档目录
第1章 绪论 1
1.1 研究背景与意义 1
1.1.1 零售安全与智能视频监控需求 1
1.1.2 研究的理论与工程意义 1
1.2 国内外研究现状 2
1.2.1 人体姿态估计研究进展 2
1.2.2 视频行为识别与异常检测研究进展 3
1.2.3 类别不平衡与代价敏感学习 3
1.3 研究内容与创新点 4
1.4 论文组织结构 4
第2章 相关理论与关键技术 6
2.1 深度学习与卷积神经网络基础 6
2.2 YOLO目标检测与姿态估计 6
2.2.1 YOLO单阶段检测思想 6
2.2.2 YOLO-Pose关键点输出 7
2.2.3 姿态估计评价指标 7
2.3 姿态特征表示与归一化 8
2.4 集成学习与XGBoost 8
2.4.1 梯度提升树基本原理 8
2.4.2 类别权重机制 9
2.5 行为识别与类别不平衡评价指标 9
2.6 本章小结 10
第3章 系统需求分析与总体设计 11
3.1 系统需求分析 11
3.1.1 功能需求 11
3.1.2 性能与非功能需求 11
3.2 系统总体架构设计 12
3.3 数据流与关键技术方案 13
3.4 系统工作流程设计 14
3.5 系统技术指标与风险控制 15
3.6 本章小结 16
第4章 基于YOLO的姿态估计模块设计与实现 17
4.1 YOLOv11s-Pose模型分析 17
4.2 人体检测与关键点提取 17
4.2.1 视频帧预处理 17
4.2.2 人体检测与置信度过滤 18
4.3 34维姿态特征构建 18
4.4 视频流处理与实时性优化 19
4.5 模块实现与测试 19
4.6 本章小结 20
第5章 基于XGBoost的行为分类模块设计与实现 21
5.1 数据集构建 21
5.1.1 视频数据与样本生成 21
5.1.2 数据质量控制与划分 21
5.2 特征工程 22
5.3 类别不平衡处理策略 22
5.4 XGBoost分类器设计 23
5.5 模型训练与优化 24
5.6 模型评估与结果分析 24
5.7 特征重要性与可解释性讨论 25
5.8 自动化训练流水线 25
5.9 本章小结 26
第6章 系统实现、测试与结果分析 27
6.1 系统开发环境与集成实现 27
6.2 图形用户界面实现 27
6.3 正常行为与可疑行为检测功能测试 29
6.3.1 可疑行为检测示例 29
6.3.2 正常行为检测示例 30
6.3.3 同一视频中的状态变化 32
6.4 视频分析完成与结果输出测试 35
6.5 系统功能与性能测试 35
6.6 实验结果综合分析 36
6.7 系统局限性与应用边界 37
6.8 本章小结 38
第7章 总结与展望 39
7.1 研究工作总结 39
7.2 主要创新与实践价值 40
7.3 研究不足 40
7.4 未来工作展望 40
参考文献 42
致谢 44
附录A 系统主要配置参数 45
附录B 系统使用说明 46
配套项目
作者联系
作者信息
原创作者:bob(可提供二次开发有偿修改服务)
项目编号:AI-47-P
原创声明:本项目为原创作品
联系方式
开源协议
本项目采用AGPL-3.0开源协议,允许个人和组织自由使用、修改和分发代码,但基于本项目的衍生作品必须同样开源,且用于提供网络服务时需向用户提供完整源代码。本项目仅供学习研究使用,作者不对使用本项目产生的任何后果承担责任,使用者应遵守当地法律法规,合理合法使用本项目。如本项目对您的研究或工作有所帮助,欢迎引用并注明出处。

评论(2)