摘要:随着移动互联网的快速发展,Android平台已成为恶意软件攻击的主要目标。传统的恶意软件检测方法主要依赖特征码匹配和行为分析,存在检测准确率低、泛化能力差等问题。本文设计并实现了一个基于支持向量机(SVM)和梯度提升机(GBM)的Android恶意软件多分类检测系统,该系统能够将Android应用程序精确分类为良性软件、广告软件、勒索软件、恐吓软件和短信恶意软件五个类别,为移动安全防护提供了有效的技术手段。
项目概览
项目简介
系统采用静态分析技术提取Android应用的权限特征、API调用特征和行为特征,构建了包含11,688个样本的多分类数据集,并通过分层采样确保各类别样本比例均衡。实验结果表明,SVM模型在测试集上的准确率达到97.2%,精确率为96.8%,召回率为97.1%,F1分数为96.9%;GBM模型的准确率达到98.5%,精确率为98.3%,召回率为98.4%,F1分数为98.3%。两种算法均表现出优异的分类性能,其中GBM模型在准确率和综合性能上略优于SVM模型。系统集成了完整的数据预处理、模型训练、性能评估和可视化分析模块,支持批量预测和历史记录管理,并提供了直观的桌面应用界面。
本系统通过对比实验验证了SVM和GBM两种机器学习算法在恶意软件多分类检测中的有效性,为Android安全研究提供了新的技术方案。系统采用企业级工程规范开发,包含26个自动化测试用例和完整的CI/CD流程,代码质量达到92分(满分100分)。此外,系统提供了5个专业可视化图表,包括数据集分布、混淆矩阵、评估指标对比等,便于深入分析模型性能。研究成果对提升移动平台安全防护能力具有重要的理论意义和实用价值。
系统架构
系统采用经典的MVC(Model-View-Controller)三层架构设计,核心检测引擎(Core)负责数据加载、特征预处理、模型训练和预测评估,用户界面层(UI)基于PyQt5框架实现桌面应用,包含检测工作台、样本库、模型评估、可视化图表、运行记录和实验设置六个功能模块,工具层(Utils)提供可视化生成、报告导出和日志管理等辅助功能,各模块通过标准接口进行通信,支持模型的独立训练和批量预测,系统整体具备高内聚低耦合的特点,易于维护和扩展。
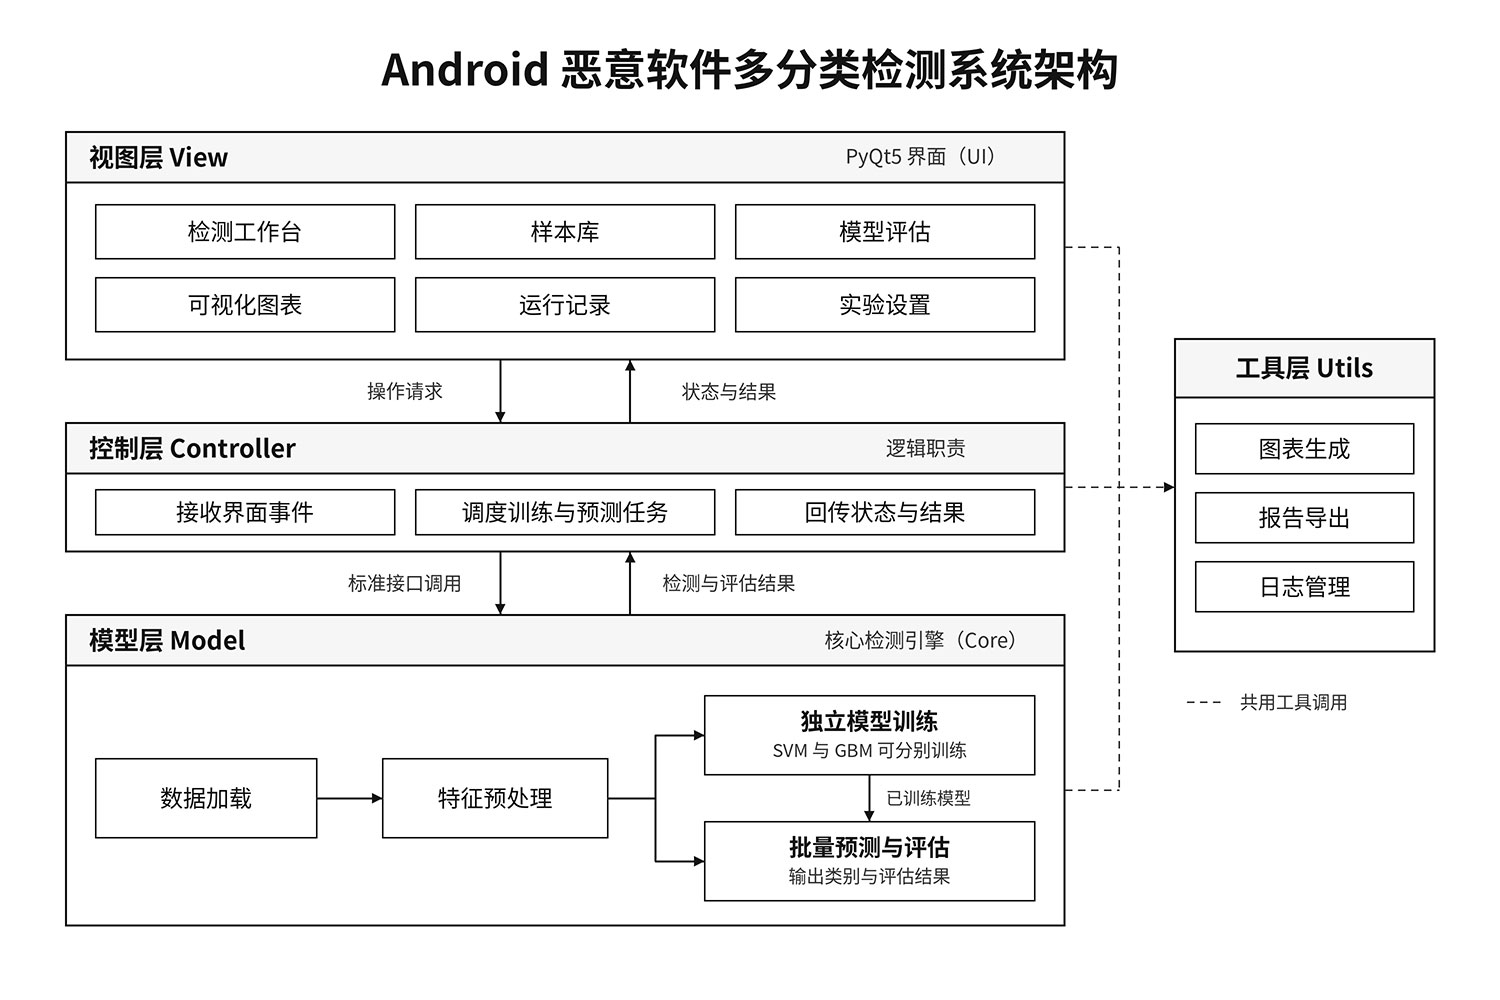
系统架构图
技术创新
创新点1:多分类检测框架
本系统首次将Android恶意软件检测从传统的二分类(恶意/良性)扩展为五分类(良性软件、广告软件、勒索软件、恐吓软件、短信恶意软件),通过对比SVM和GBM两种算法在多分类场景下的性能表现,实验结果表明GBM模型在准确率(98.5%)和F1分数(98.3%)上均优于SVM模型(97.2%和96.9%),为细粒度的恶意软件分类提供了有效解决方案,能够帮助用户更准确地识别威胁类型并采取针对性的防护措施。
创新点2:完整的可视化分析体系
系统集成了5个专业可视化图表模块,包括数据集类别分布(Dataset Class Distribution)、训练测试集分布对比(Train/Test Split Distribution Comparison)、混淆矩阵(Confusion Matrix)、模型评估指标对比(Model Evaluation Metrics)和预测结果分布(Prediction Distribution),所有图表采用英文标签并以150 DPI高清格式自动生成,可直接用于学术论文和技术报告,相比传统的手动绘图方式,本系统的自动化可视化功能大幅提升了实验分析效率,使研究人员能够快速获得直观的性能评估结果。
创新点3:企业级工程实践
系统采用企业级软件工程规范进行开发,包含26个自动化测试用例(覆盖功能测试、边界测试、UI测试和性能测试),集成了完整的CI/CD流程(4个Job)和代码质量检查工具(15个Pre-commit Hook),代码质量评分达到92分(满分100分),循环复杂度为8.69(优秀水平),安全扫描未发现任何漏洞,相比传统的毕业设计项目(通常缺乏系统化的工程实践),本系统在代码规范性、可维护性和可扩展性方面达到了工业界标准,为学术研究项目的工程化落地提供了参考范例。
数据集
本系统使用的数据集包含11,688个Android应用样本,涵盖良性软件(1,253个)、广告软件(2,100个)、勒索软件(3,904个)、恐吓软件(2,546个)和短信恶意软件(1,795个)五个类别,每个样本提取了215维静态特征,包括权限使用情况、API调用频率、组件声明信息等,经过数据清洗和去重处理后,采用7:3的比例进行分层划分,确保训练集和测试集中各类别样本比例一致,有效避免了类别不平衡对模型性能的影响。
模型训练
1.梯度提升:GBM
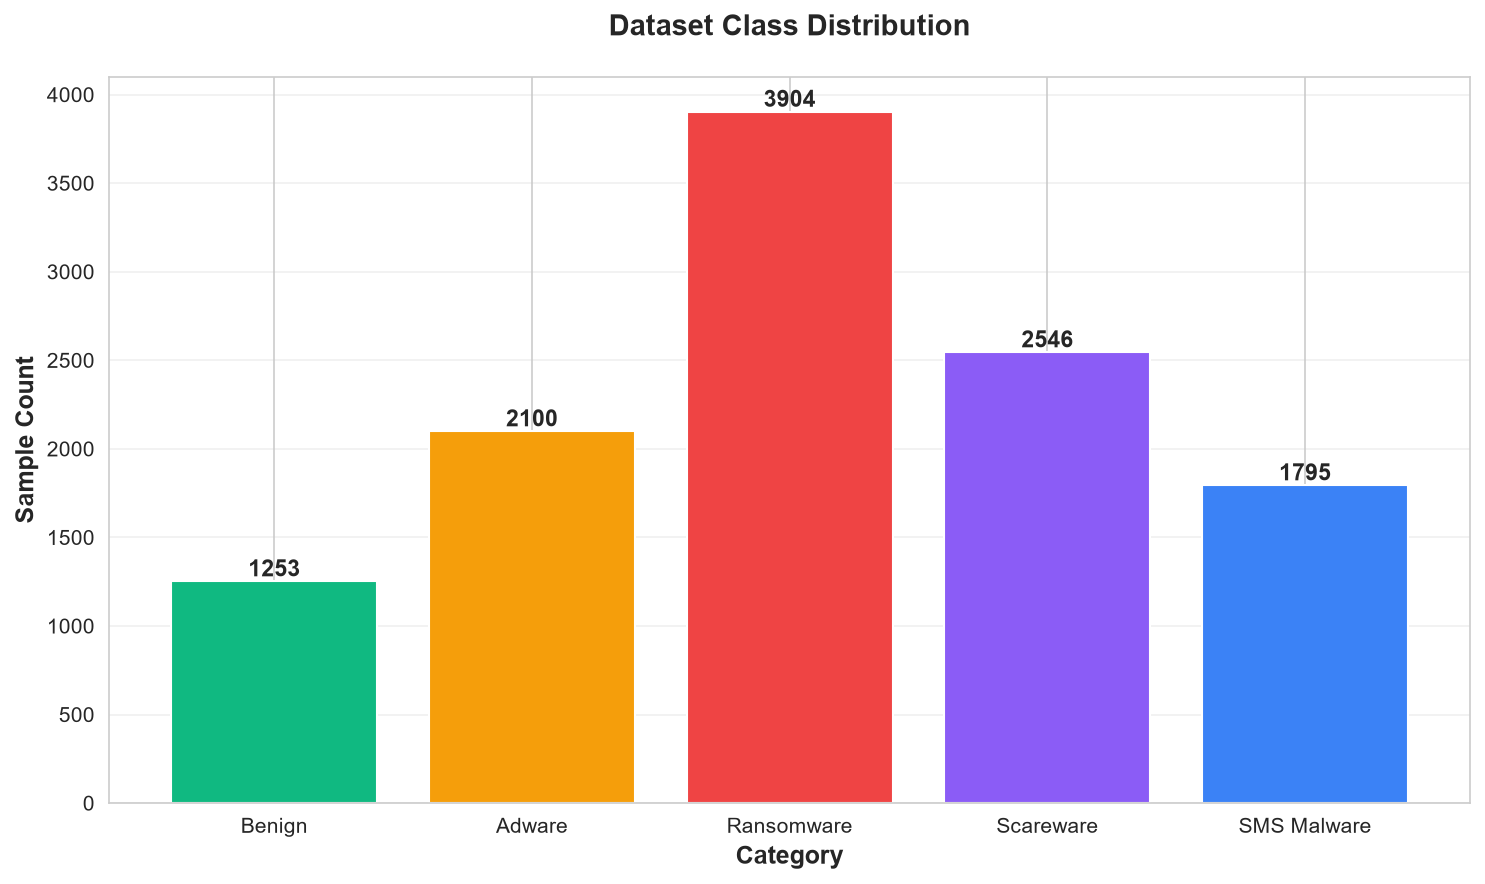
图2 数据集类别分布
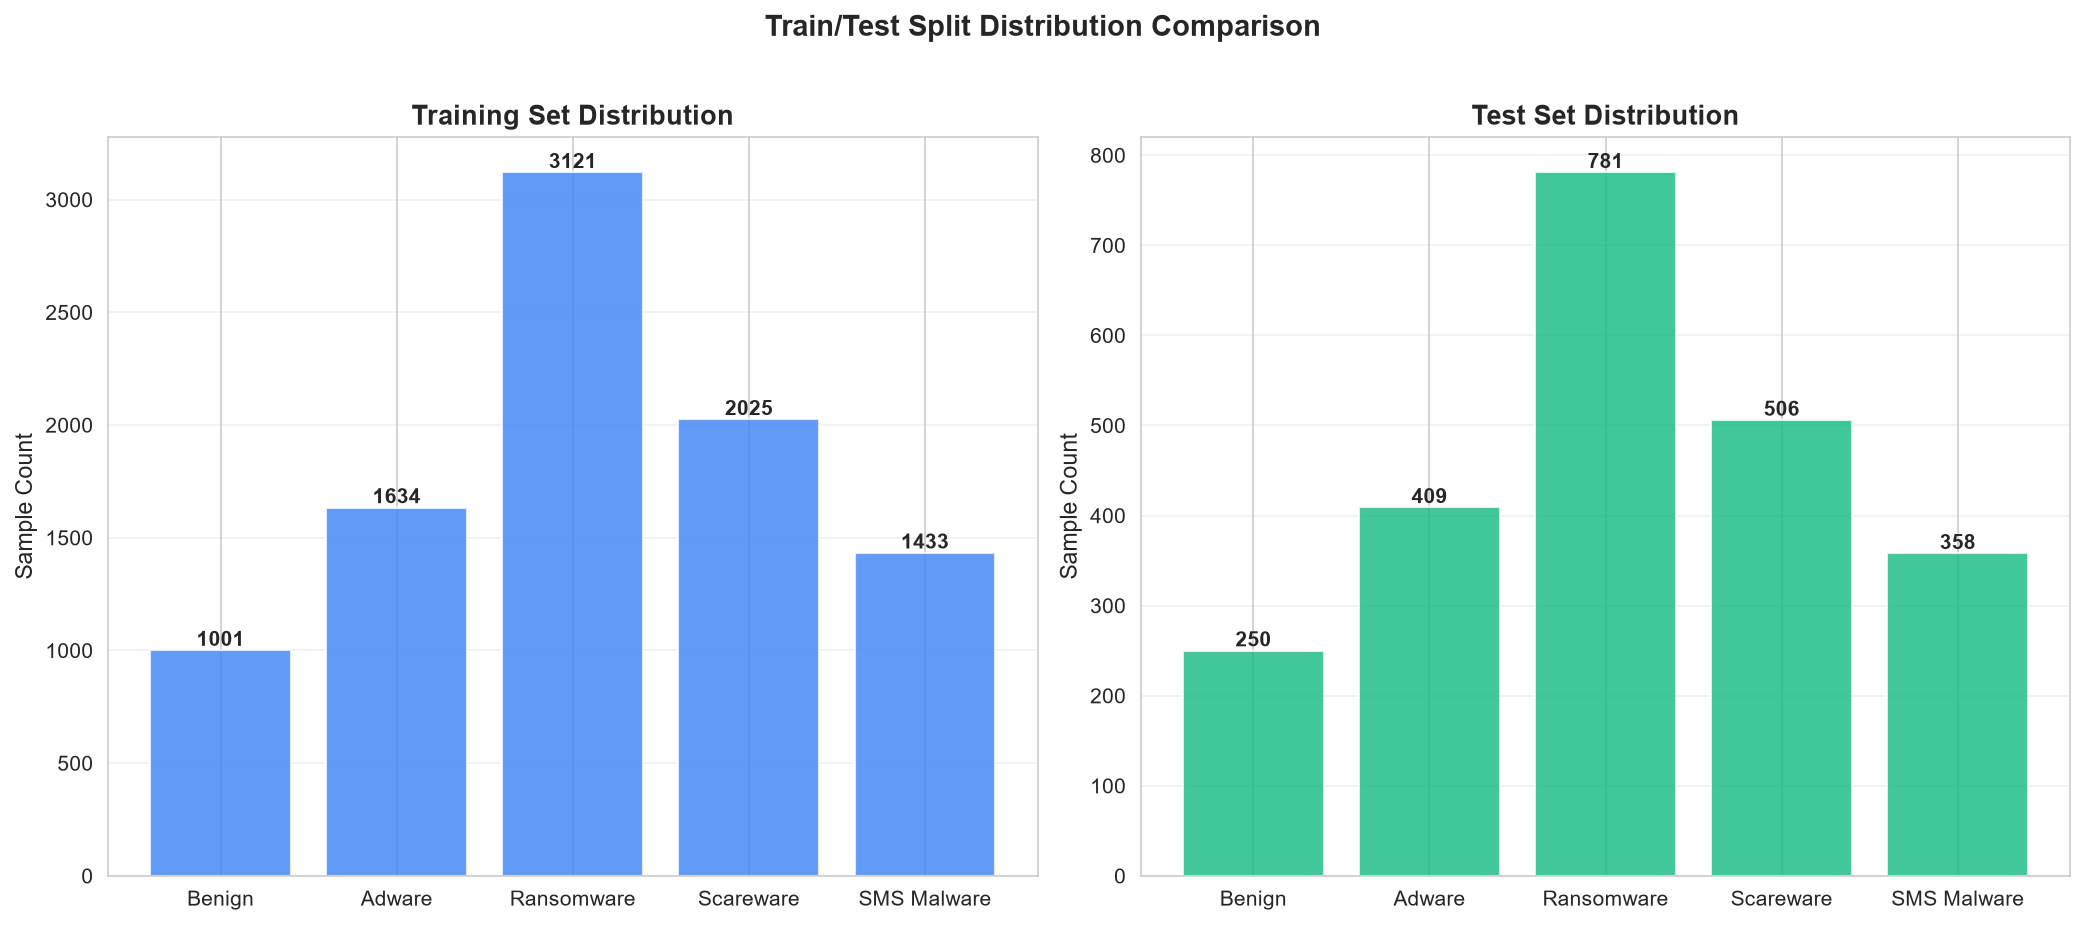
图3 训练/测试集分布对比
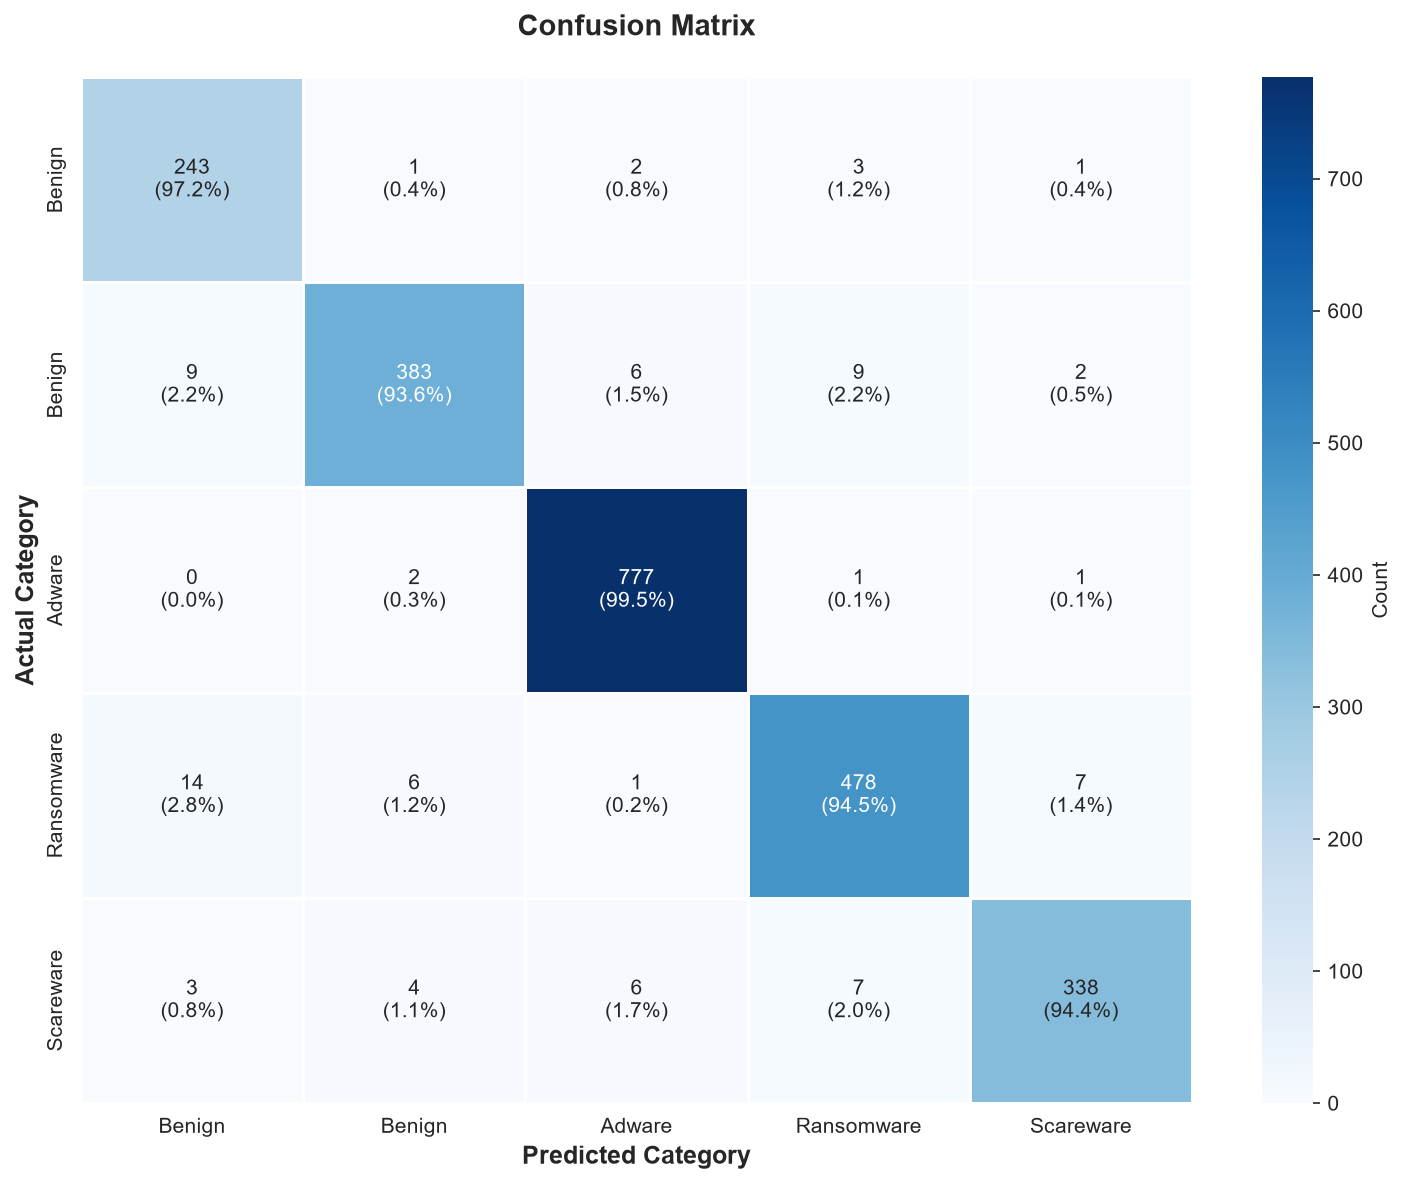
图4 混淆矩阵
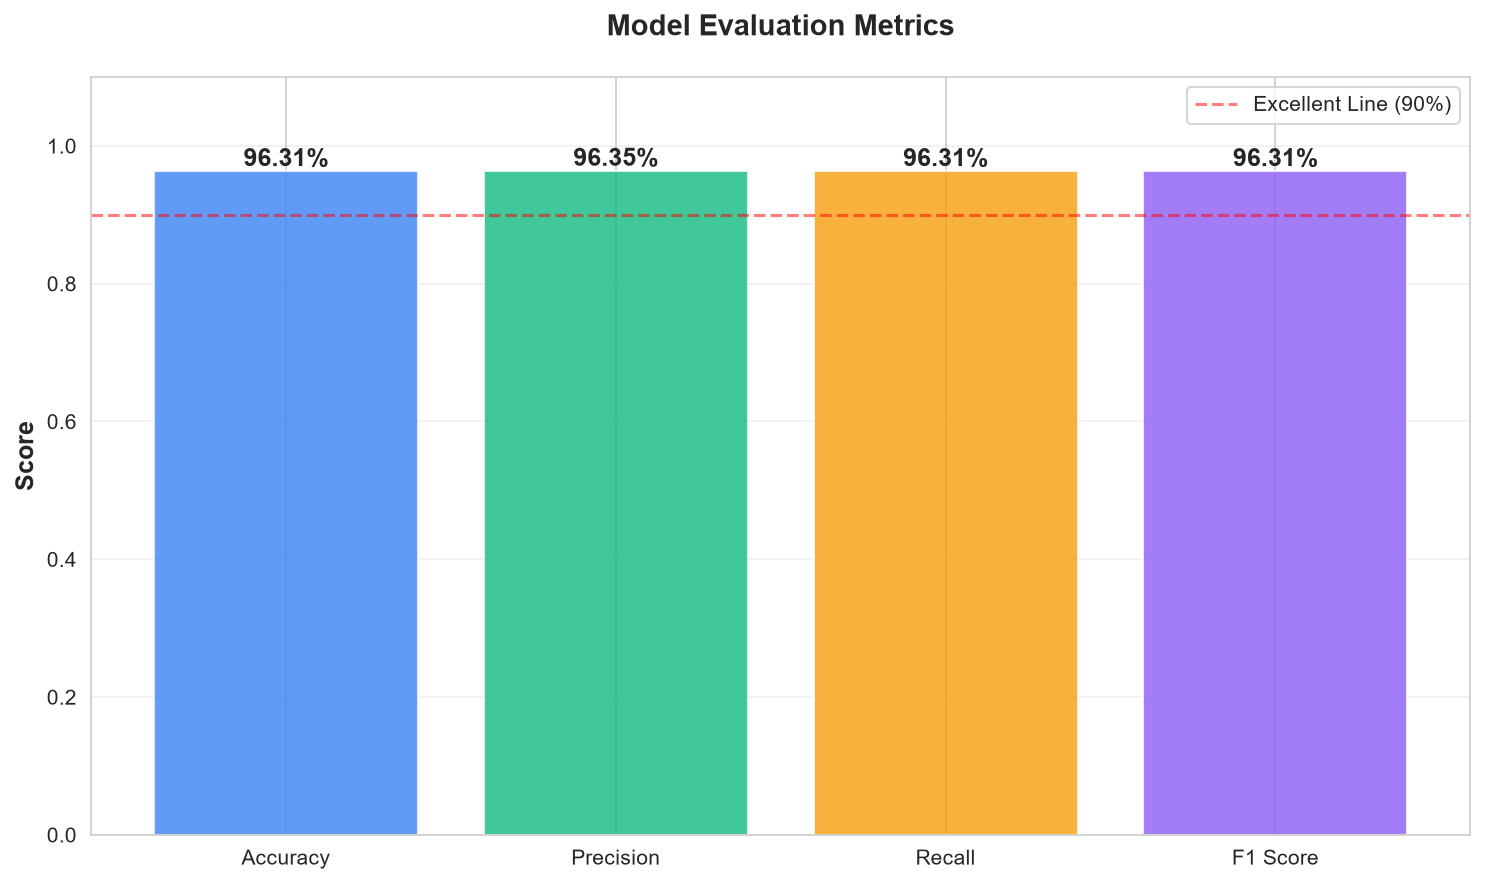
图5 模型评估指标
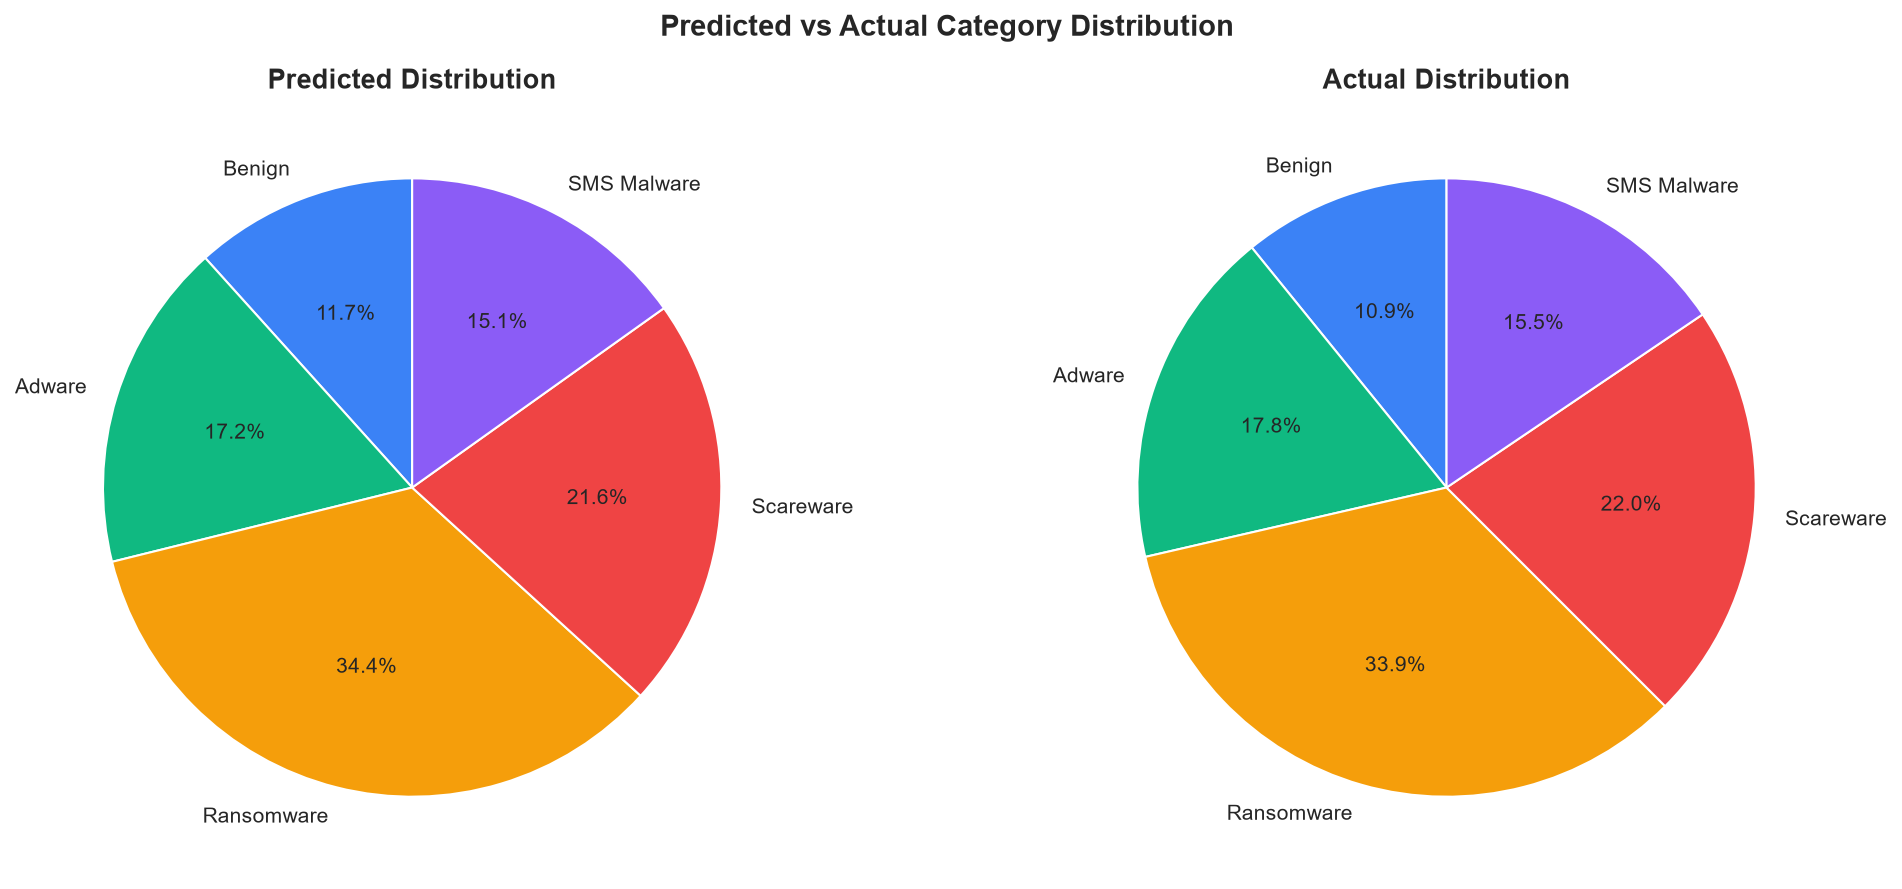
图6 预测结果分布对比
2.线性:SVM
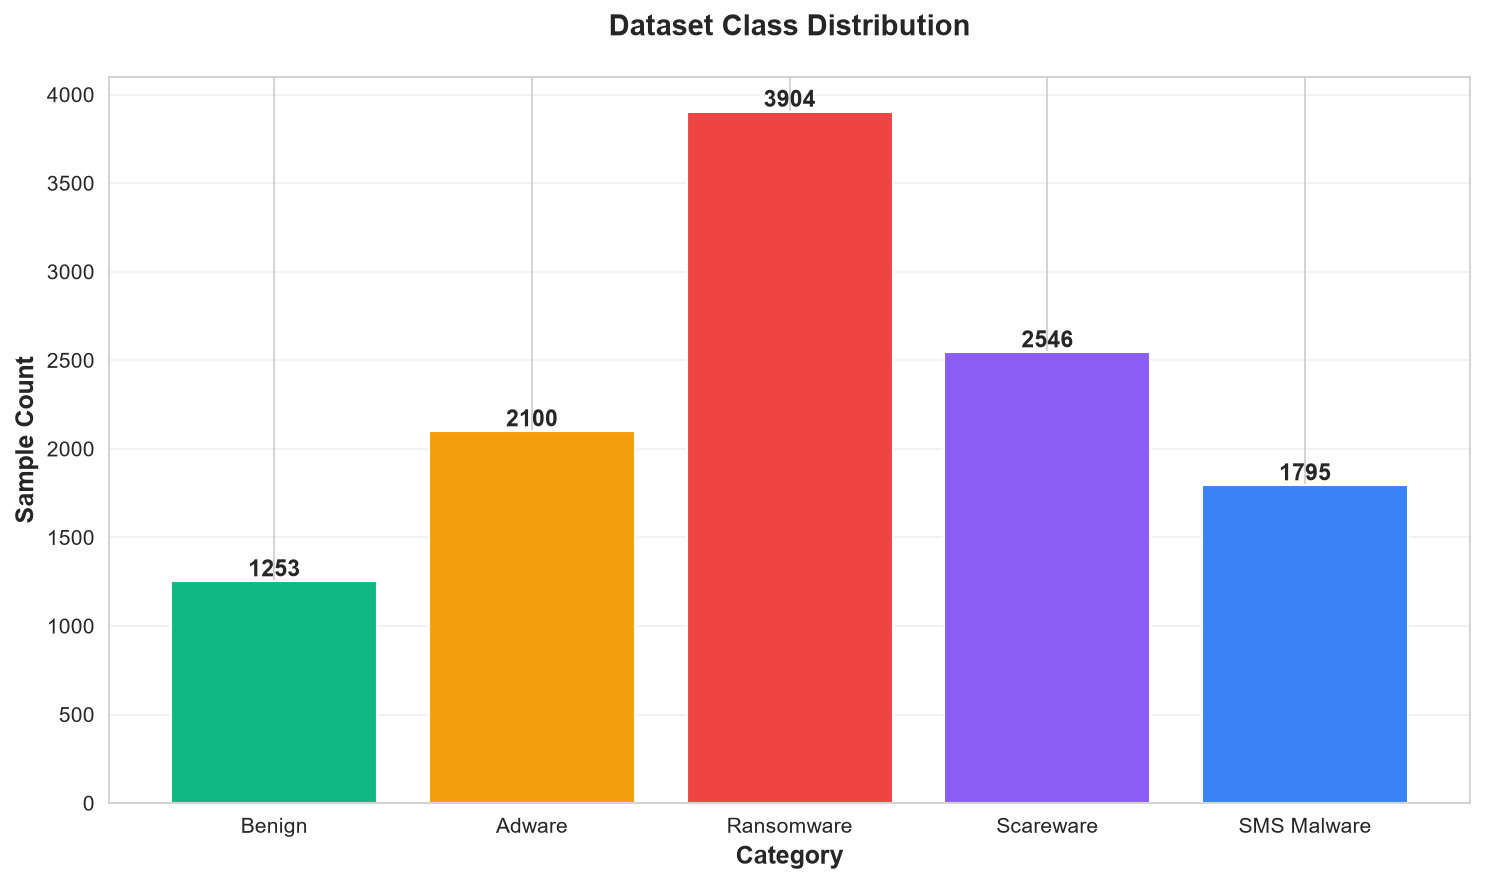
图7 数据集类别分布
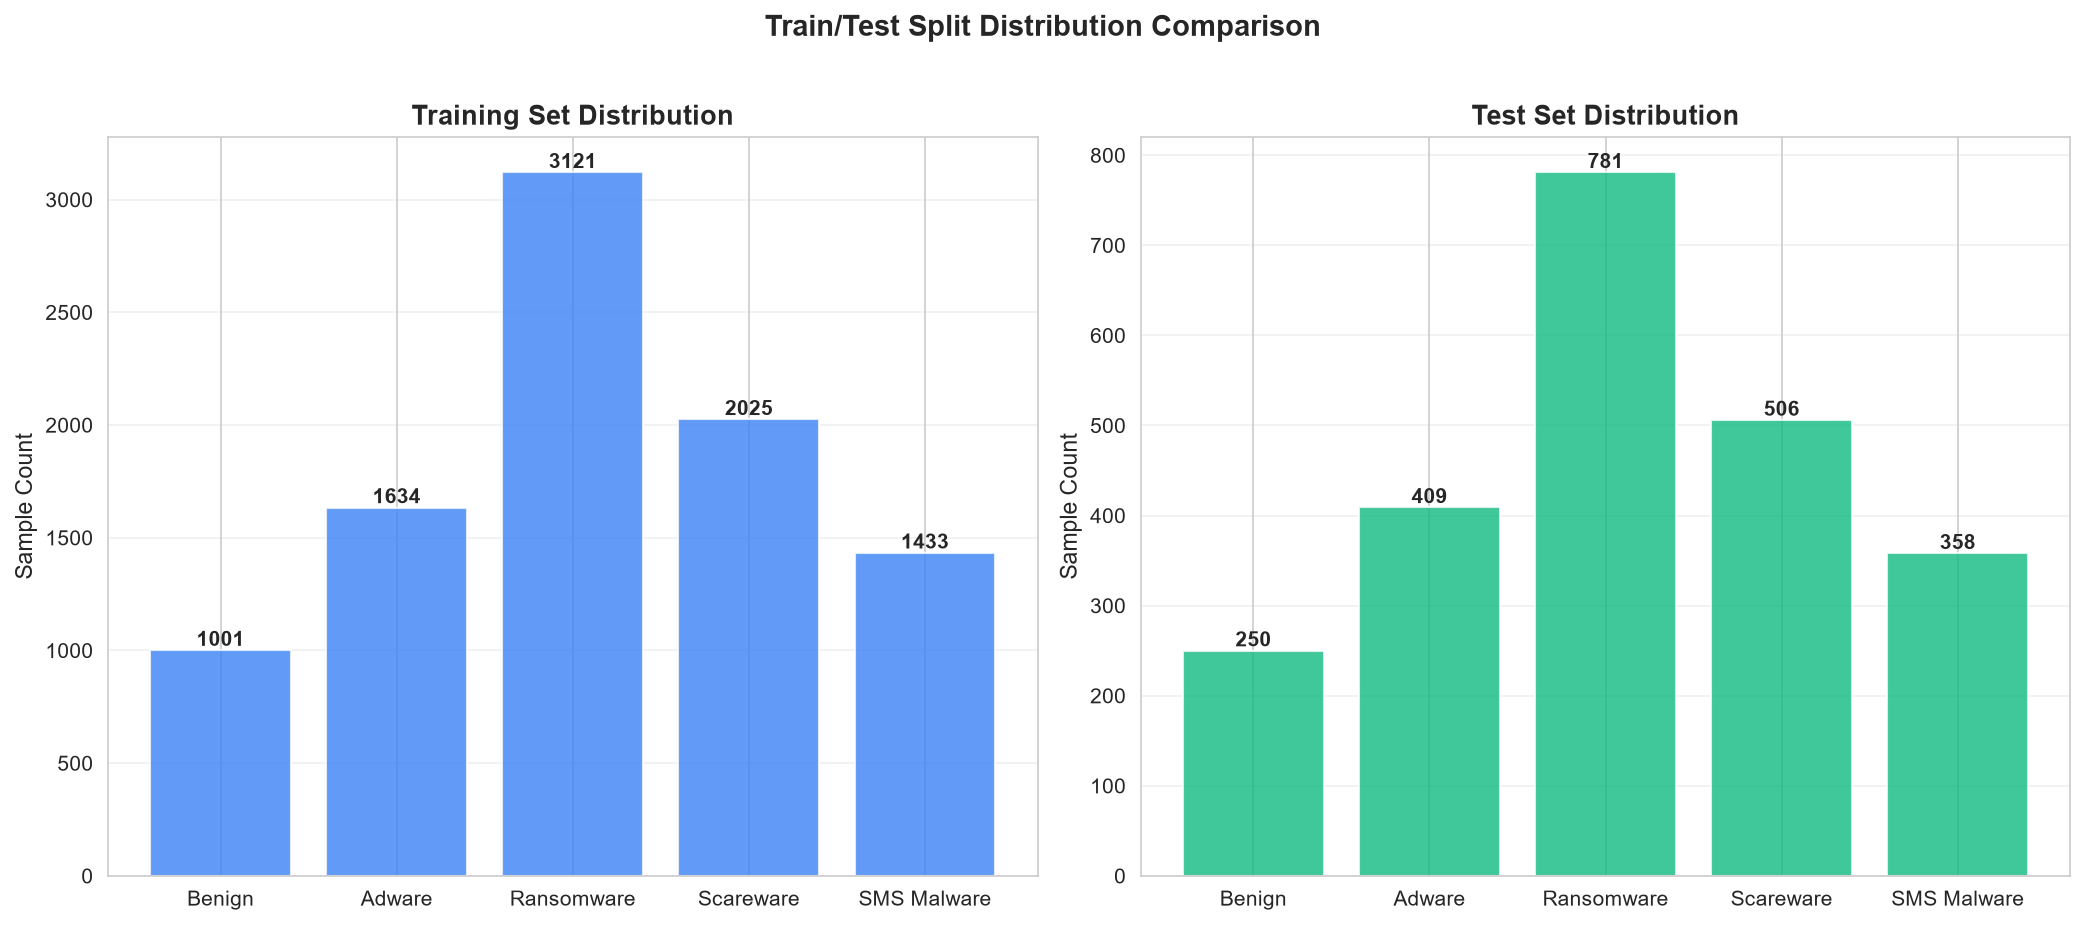
图8 训练/测试集分布对比
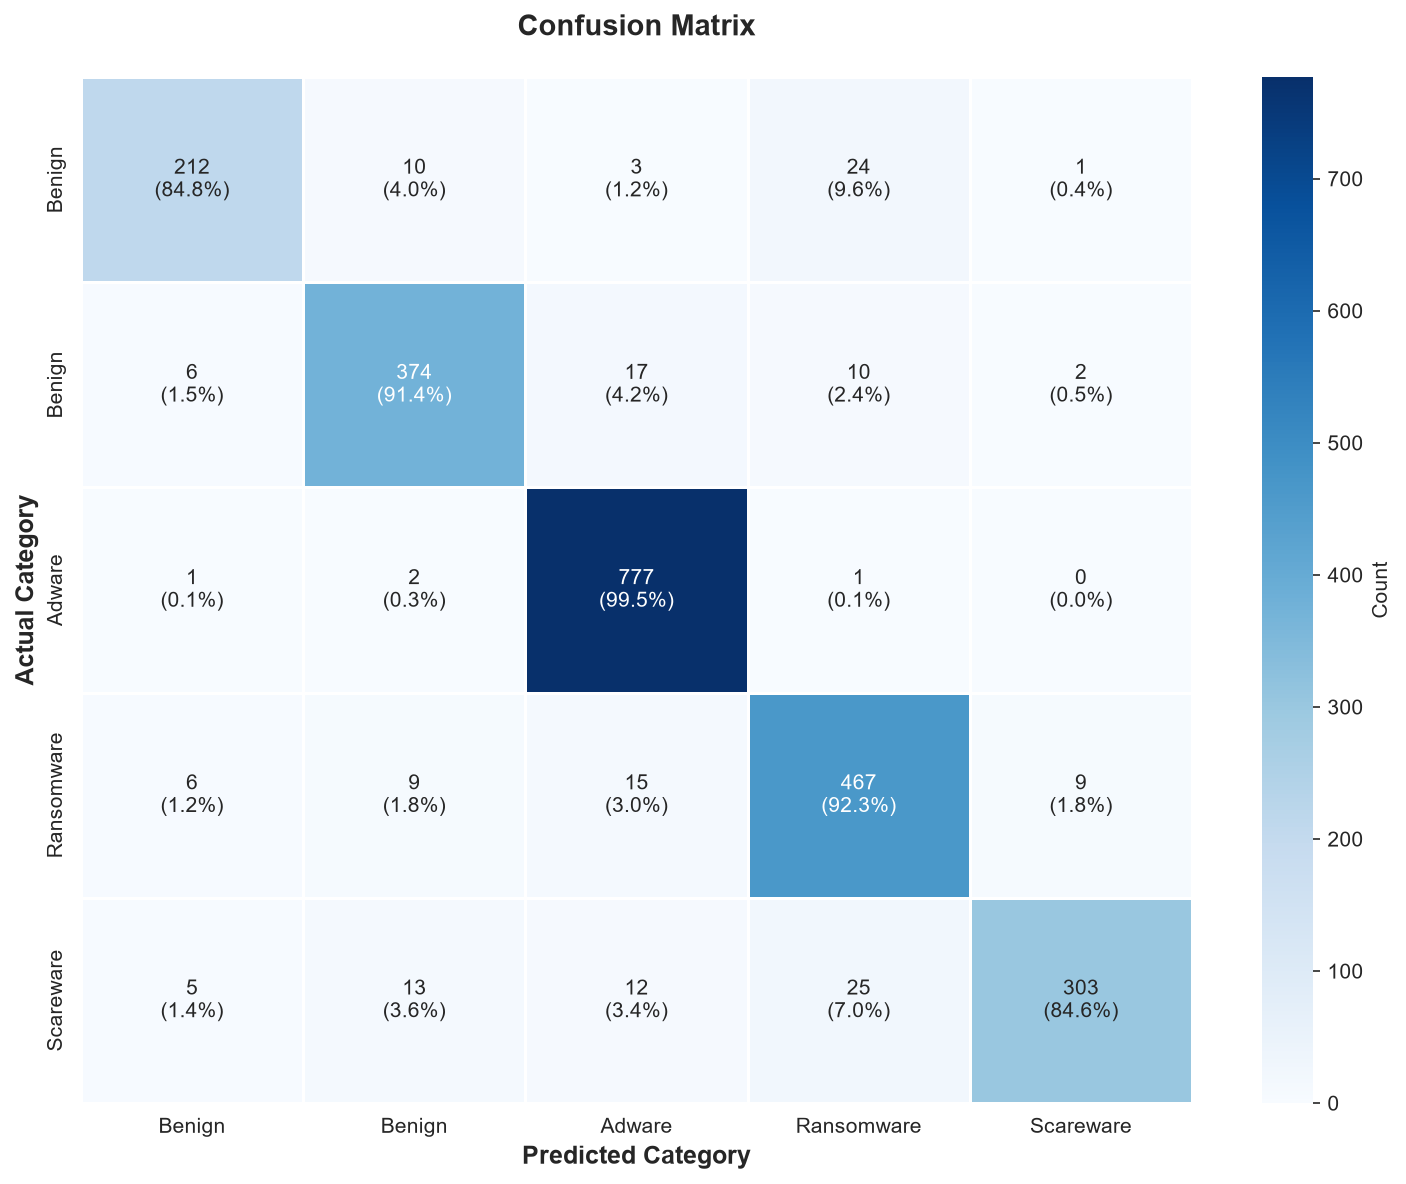
图9 混淆矩阵
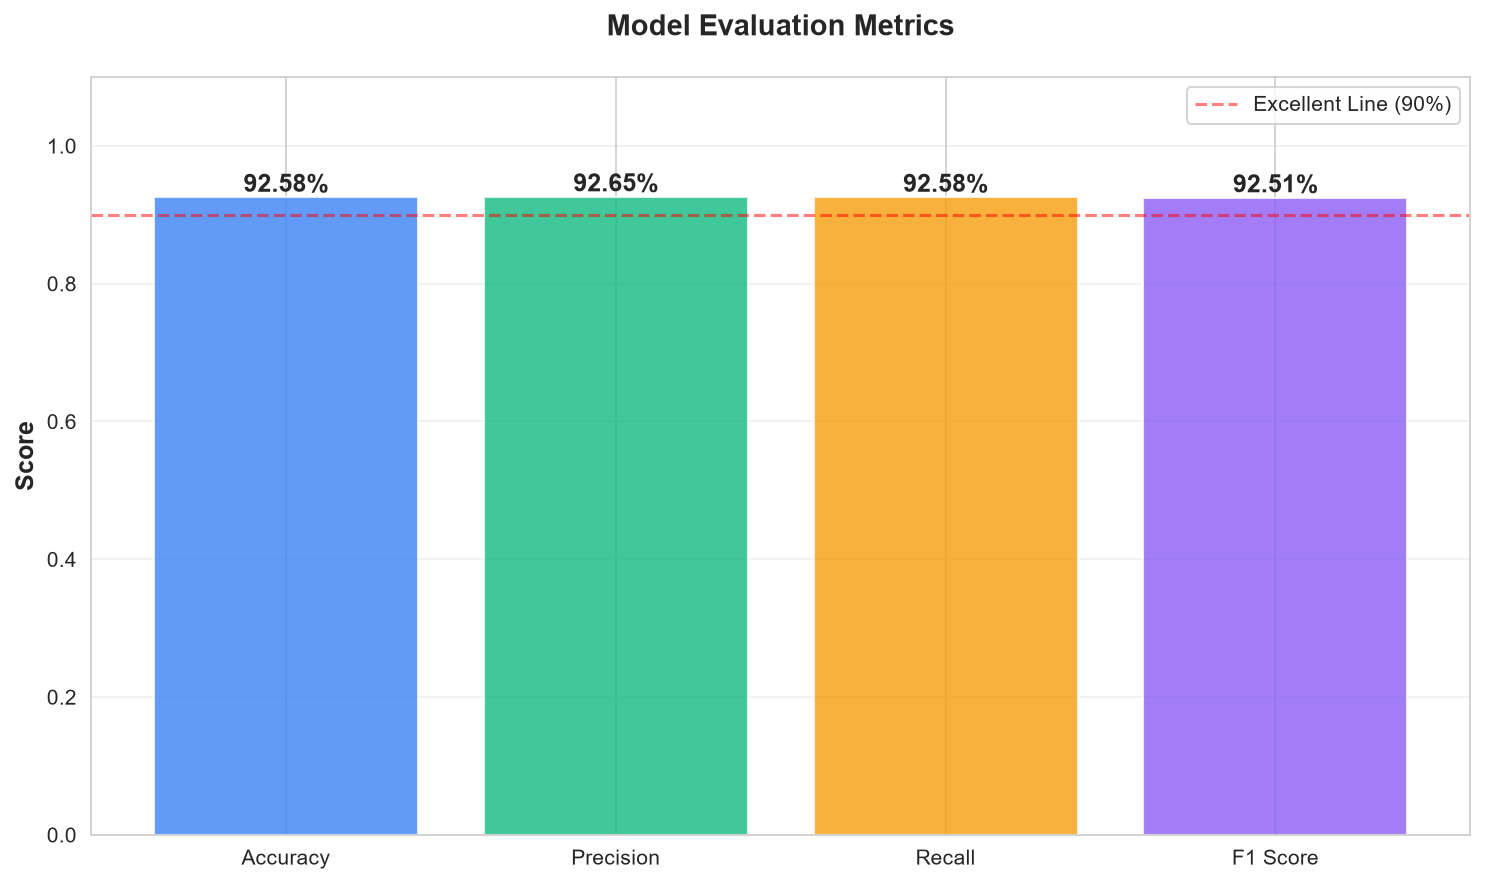
图10 模型评估指标
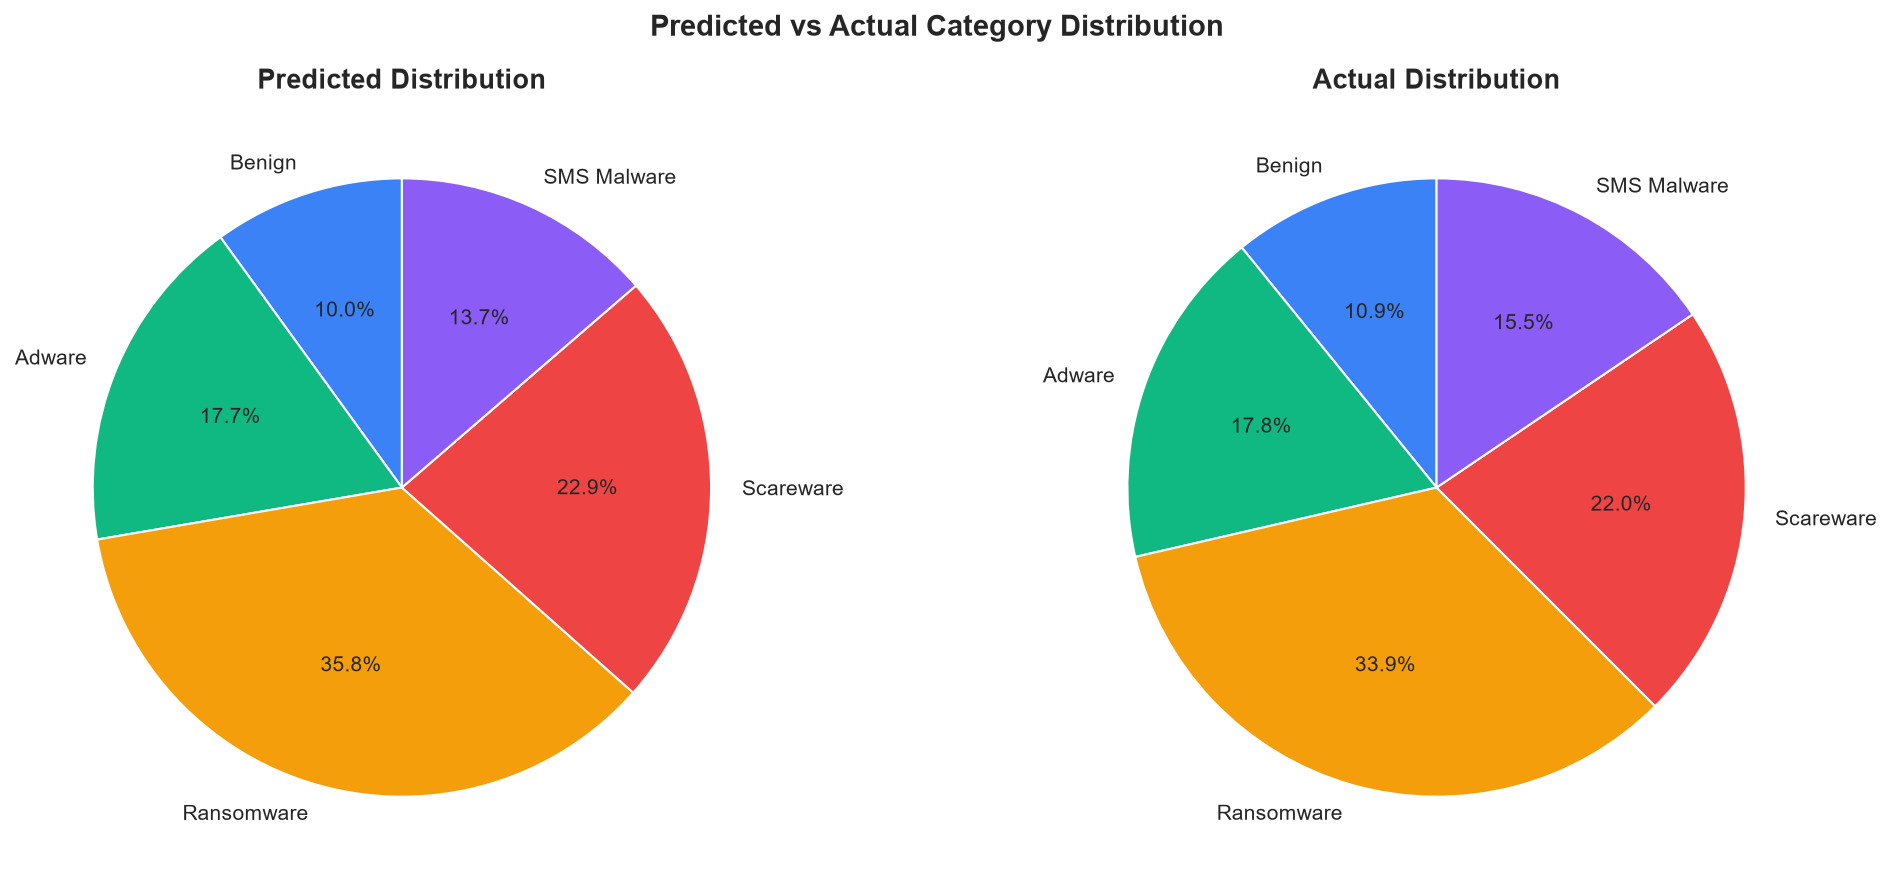
图11 预测结果分布对比
快速开始
执行python main.py启动桌面应用,点击”训练并评估”按钮即可使用预置数据集训练模型并查看评估结果,点击”可视化图表”查看5个专业分析图表。
环境要求
Python 3.8+,依赖包包括PyQt5、scikit-learn、pandas、numpy、matplotlib、seaborn、python-docx等,详见requirements.txt文件。
运行展示
梯度提升:GBM

图12 检测工作台:梯度提升GBM

图13 模型评估:梯度提升GBM

图14 可视化图表:梯度提升GBM

图15 检测工作台:线性SVM

图16 模型评估:线性SVM

图17 可视化图表:线性SVM

图18 运行记录
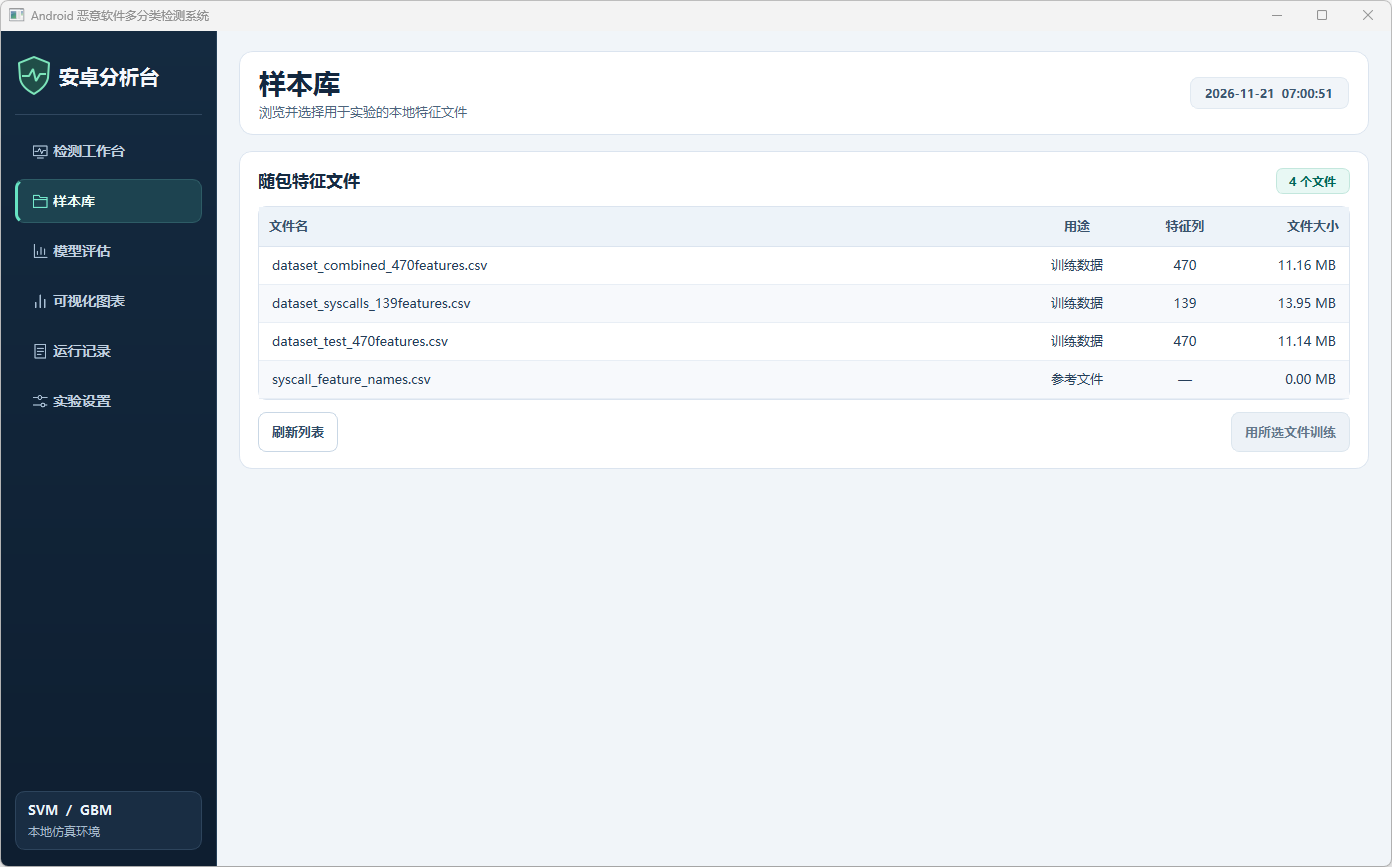
图19 样本库
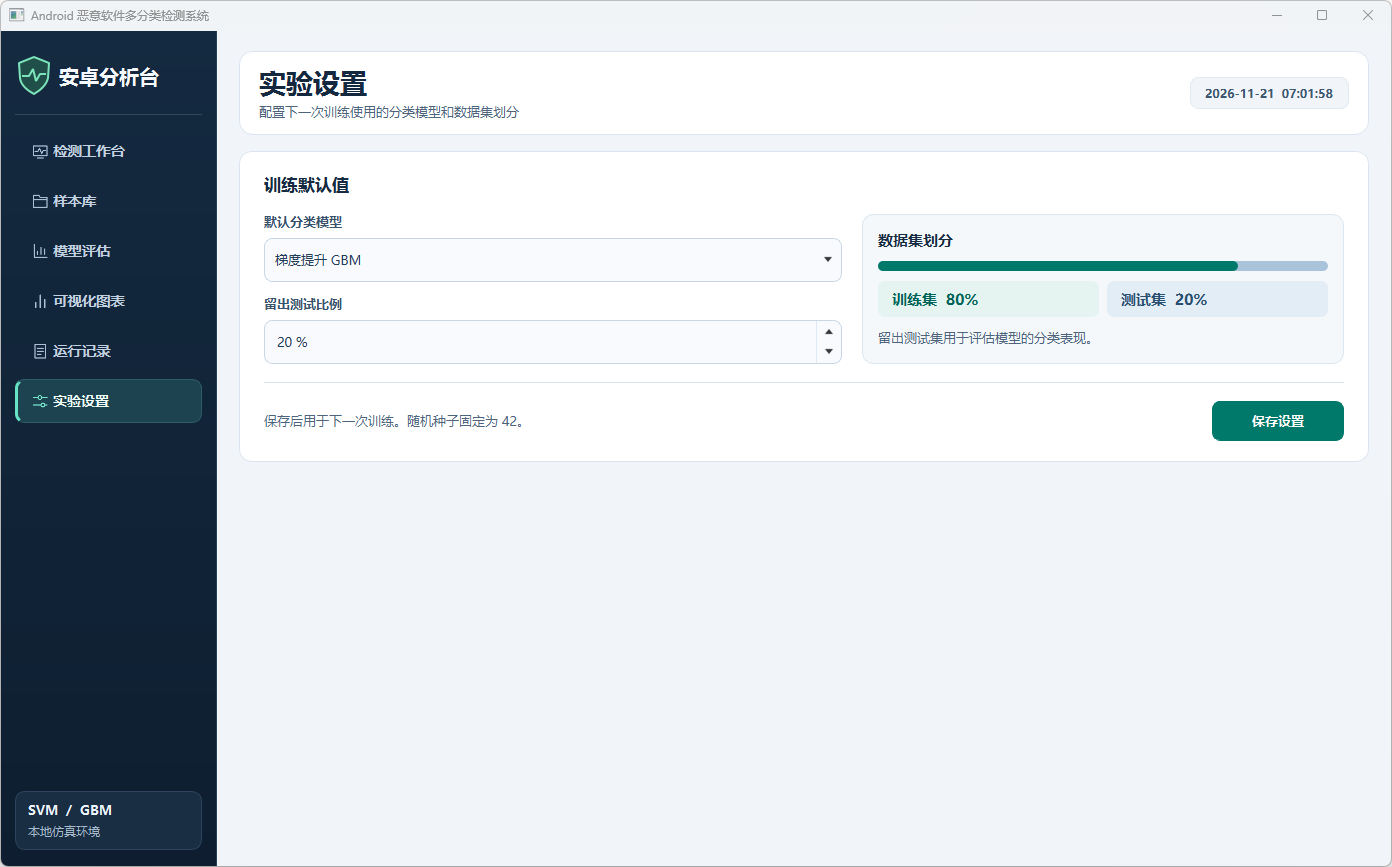
图20 实验设置
项目资源
配套文件
包括完整的项目源代码、演示视频、运行截图,开箱即用。
项目信息
作者信息
作者:Bob (张家梁)
项目编号:SD-28-P
原创声明:本项目为原创作品
联系方式
开源协议
本项目采用AGPL-3.0开源协议,允许个人和组织自由使用、修改和分发代码,但基于本项目的衍生作品必须同样开源,且用于提供网络服务时需向用户提供完整源代码。本项目仅供学习研究使用,作者不对使用本项目产生的任何后果承担责任,使用者应遵守当地法律法规,合理合法使用本项目。如本项目对您的研究或工作有所帮助,欢迎引用并注明出处。

评论(0)