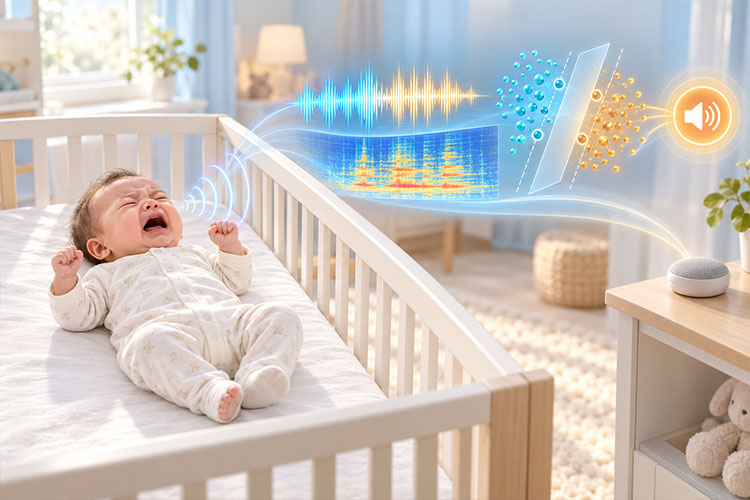
摘要:本文设计并实现了一个基于支持向量机(SVM)的实时婴儿哭声检测系统。
项目概览
项目简介
该系统采用机器学习和数字信号处理技术,提取梅尔频率倒谱系数(MFCC)、过零率(ZCR)等18个音频特征,采用径向基函数(RBF)核的支持向量机进行分类,并提供友好的中英文双语图形界面。
实验结果表明,该系统在测试数据集上达到了96.30%的准确率、96.61%的精确率和96.30%的召回率,F1分数为96.23%,具有较好的实用价值和应用前景。
系统架构
本系统采用模块化设计,主要包括四个核心模块:音频采集模块负责实时录音和文件读取;特征提取模块提取18维音频特征向量;分类模块使用经过优化的SVM模型(RBF核,C=1,gamma=0.1)进行二分类判断;图形界面模块提供实时检测、文件分析和自动监控三种工作模式,所有模块通过标准接口协同工作,实现从音频输入到检测结果输出的完整流程。
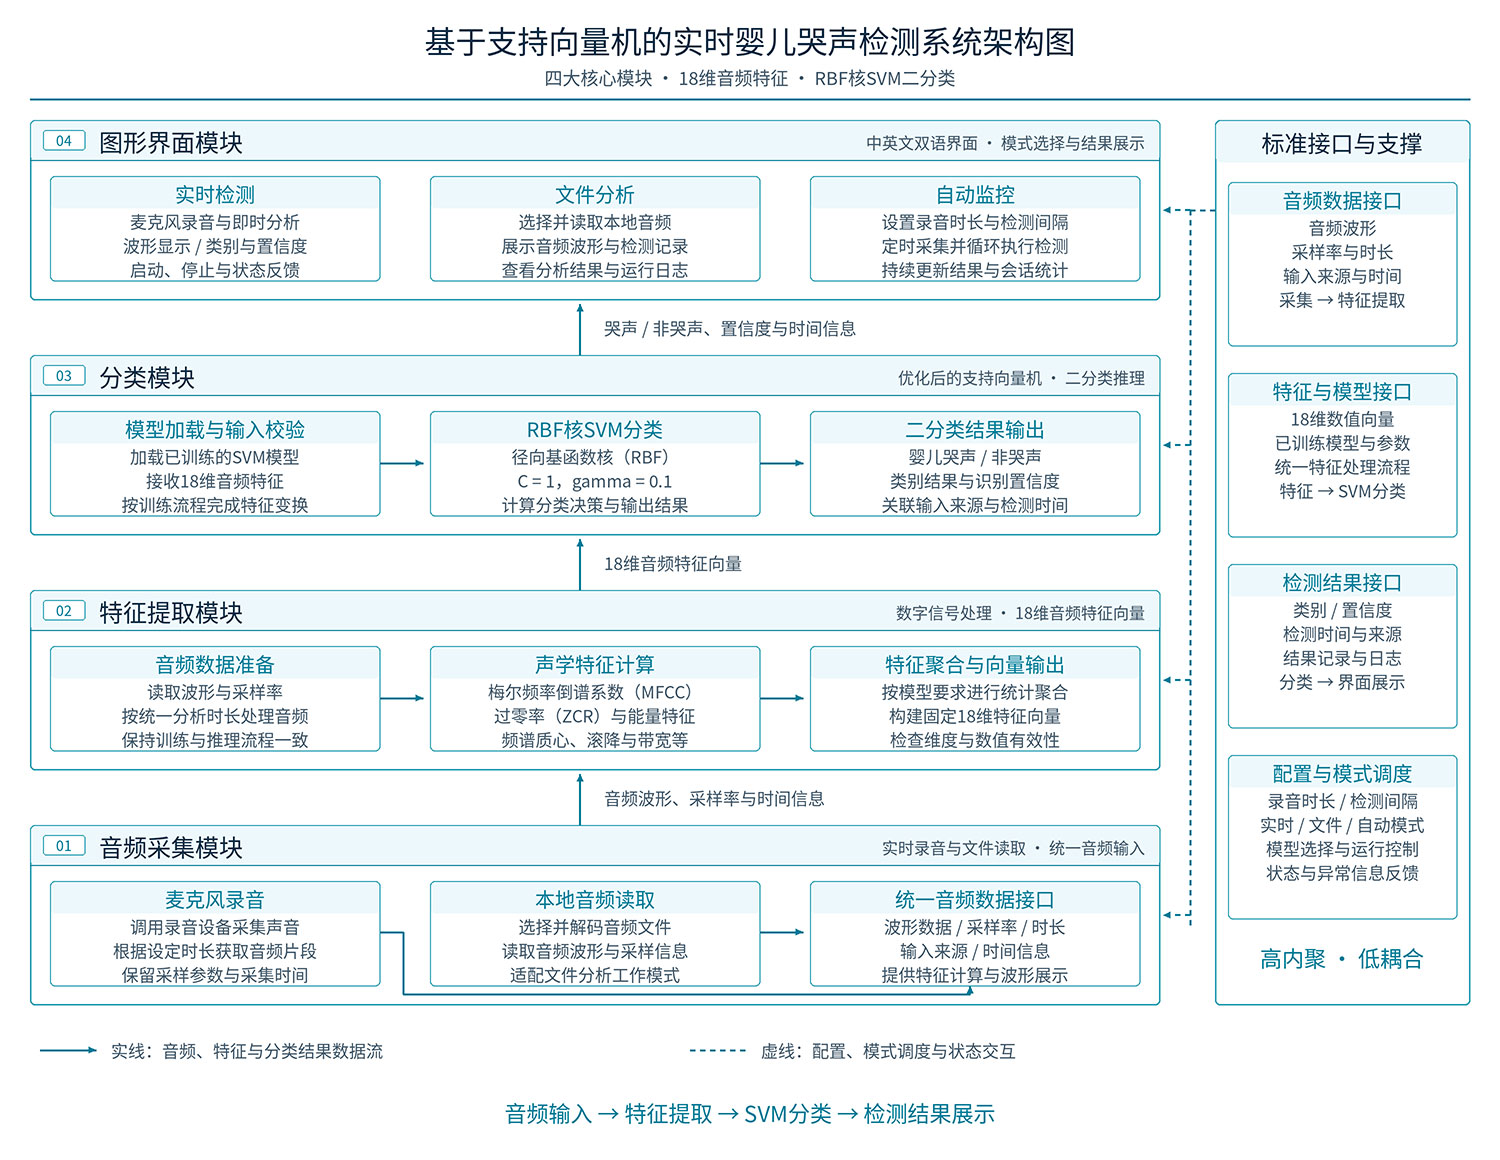
图1 系统架构图
技术创新
创新点1:综合特征工程
结合时域、频域和倒谱域的多维音频特征(MFCC、ZCR、频谱质心、频谱滚降等18个特征),通过StandardScaler标准化处理,显著提升了模型对不同环境噪声的鲁棒性和识别准确率。
创新点2:实时检测架构
设计了基于多线程的实时音频处理架构,采用5秒滑动窗口和异步特征提取机制,实现了低延迟(<1秒)的实时检测响应,满足实际应用中的即时性需求。
创新点3:智能用户交互
开发了专业级双语图形界面,集成实时波形可视化、会话历史记录和可配置的自动检测模式,提供友好的用户体验和灵活的应用场景适配能力。
快速开始
克隆项目后安装依赖(`pip install -r requirements.txt`),运行 `python launch_gui.py` 即可启动图形界面,在设置中选择预训练模型文件即可开始实时检测。
环境要求
系统需要 Python 3.7+ 环境,核心依赖包括 numpy、librosa、scikit-learn、sounddevice、soundfile 和 PyQt5,支持 Windows、Linux 和 macOS 平台。
运行展示
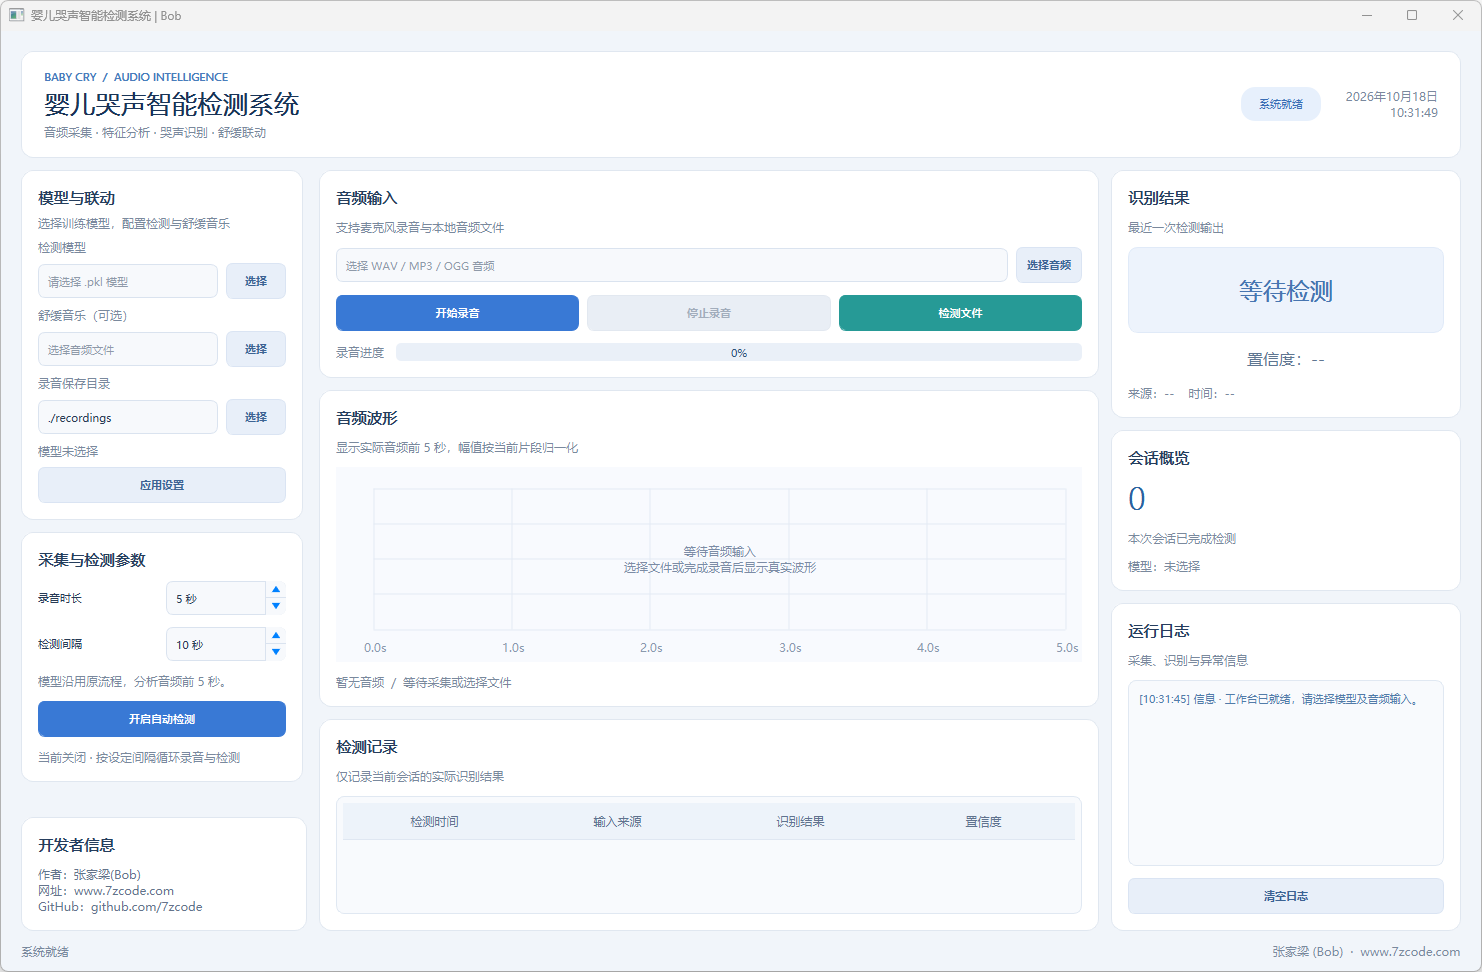
图2 系统主界面
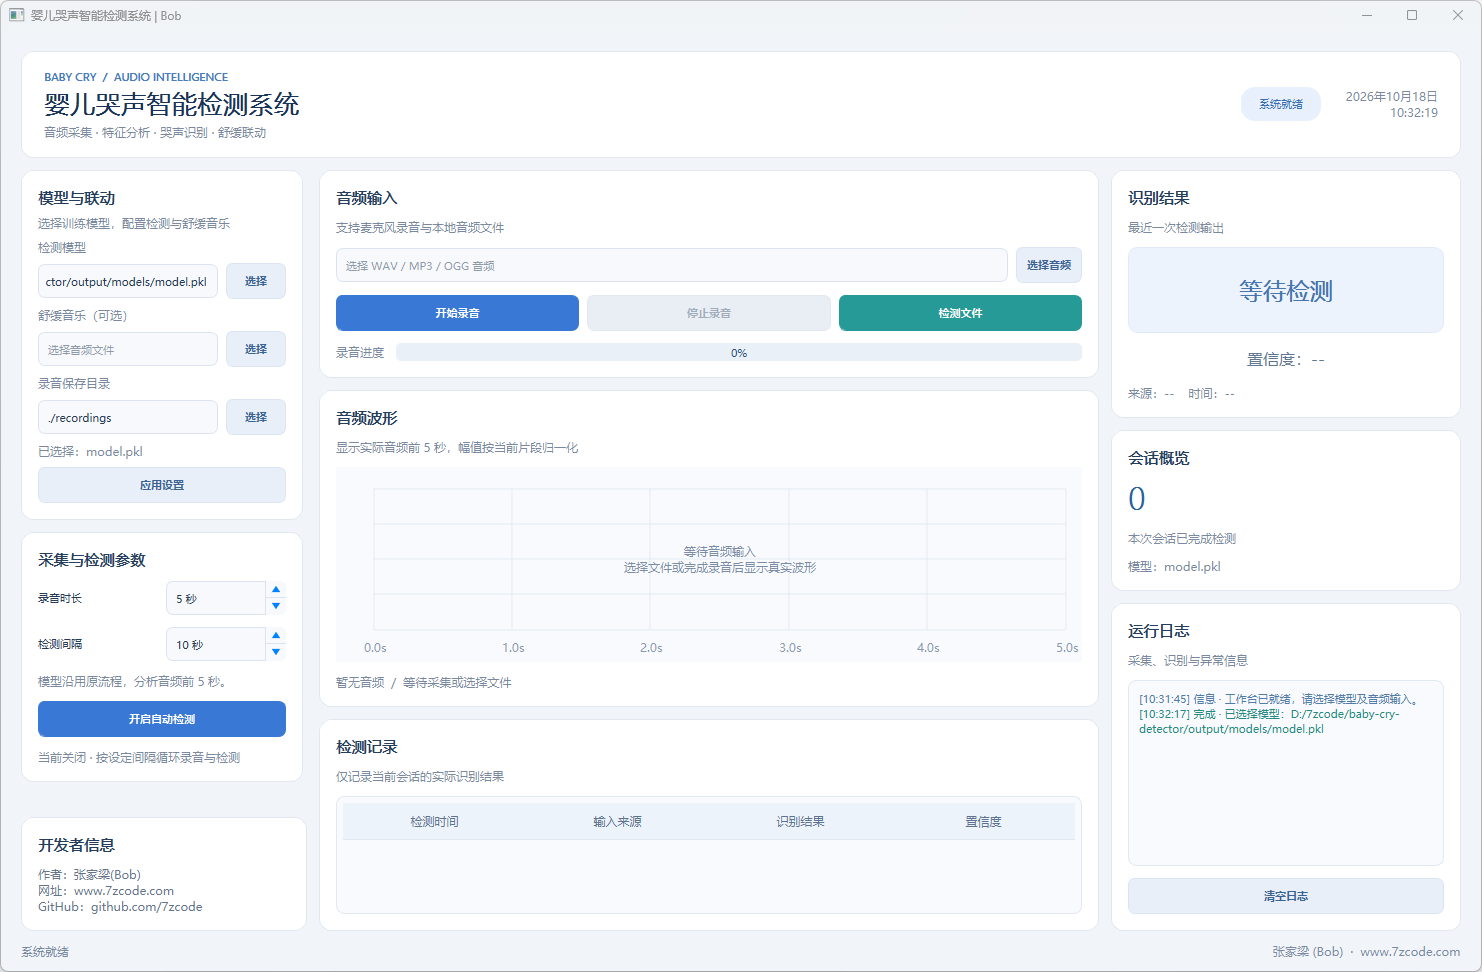
图3 加载模型
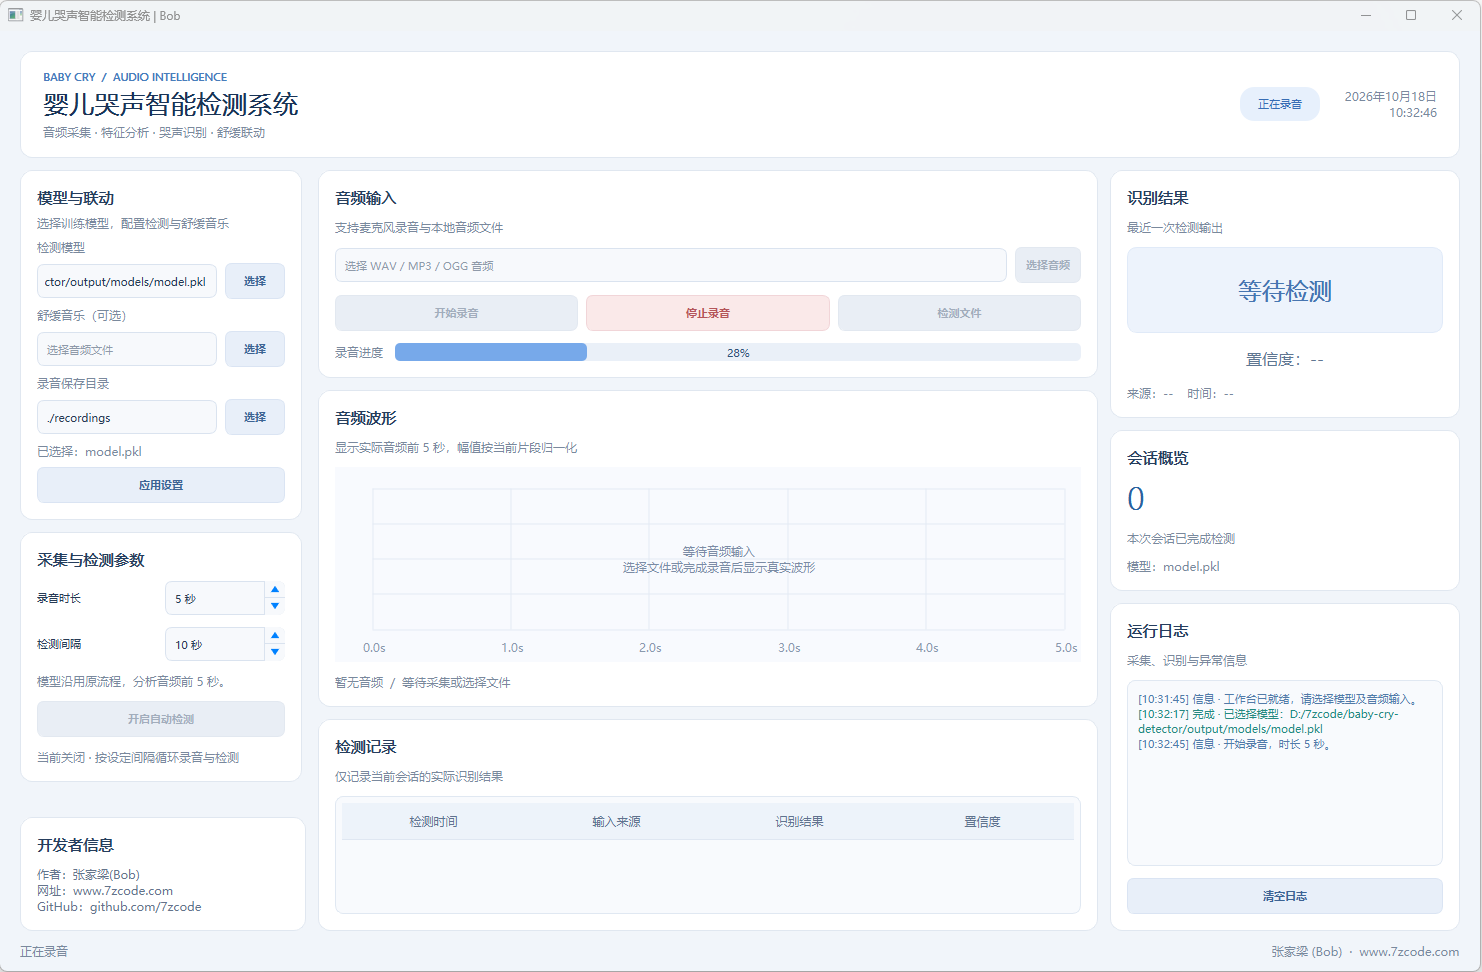
图4 开始录音
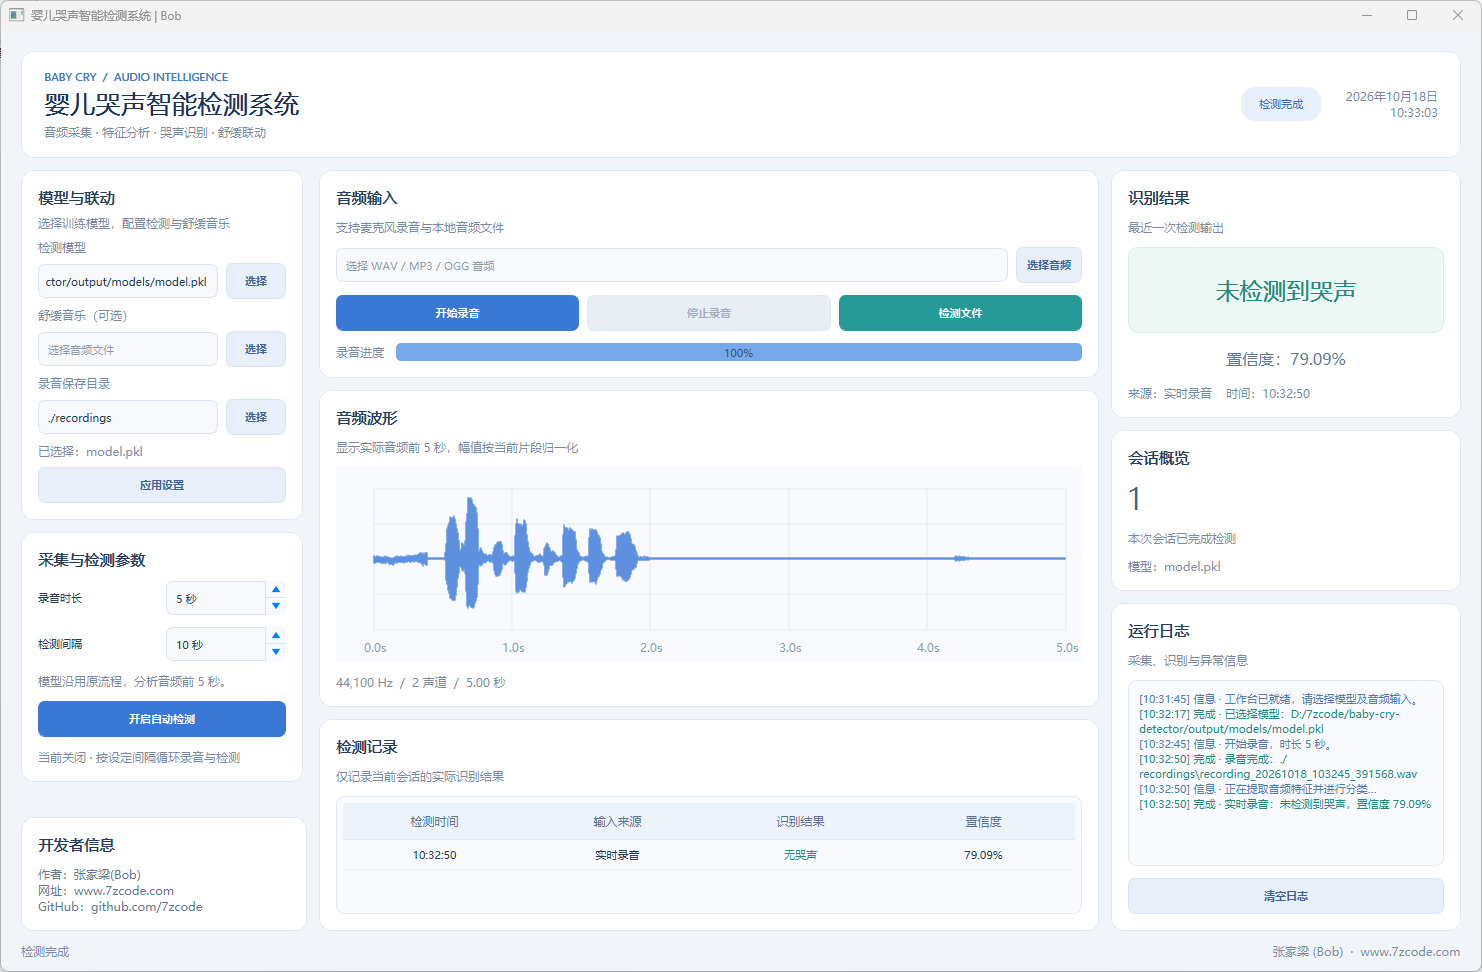
图5 录音检

图6 音频检测:婴儿哭

图7 音频检测:未检测到婴儿哭声
项目资源
配套文档
点击查看:基于机器学习与支持向量机的实时婴儿哭声检测系统设计与实现 注意:收费提供!
配套文件
包括完整的项目源代码、演示视频、运行截图,开箱即用。
项目信息
作者信息
作者:Bob (张家梁)
项目编号:AI-52-P
原创声明:本项目为原创作品
联系方式
开源协议
本项目采用AGPL-3.0开源协议,允许个人和组织自由使用、修改和分发代码,但基于本项目的衍生作品必须同样开源,且用于提供网络服务时需向用户提供完整源代码。本项目仅供学习研究使用,作者不对使用本项目产生的任何后果承担责任,使用者应遵守当地法律法规,合理合法使用本项目。如本项目对您的研究或工作有所帮助,欢迎引用并注明出处。

评论(1)